
Abliterated Model: Saat Rem AI Bisa Dicopot, Pagar Pindah ke Sistem
Bayangkan kamu pasang satpam di pintu depan, terus ternyata satpam itu bisa "dicopot" oleh siapa pun yang punya kunci gudang. Bukan disogok, bukan dibujuk. Dicopot.
Itu kira-kira yang terjadi dengan abliterated model: model AI open-weight yang kemampuan menolaknya (refusal) sudah dibuang dari bobot modelnya.
Belakangan topik ini ramai lagi gara-gara YouTuber Rasmic. Dia mengaku menyuruh model "DeepSeek V4.1 Flash Abliterated" menyerang jaringannya sendiri, dan model itu dapat akses root ke Samsung TV miliknya dalam sekitar 31 menit. Di post sebelumnya dia menulis prosesnya makan 20–30 menit dengan model berjalan dalam loop.
Saya nggak bisa memverifikasi detail serangannya, dan saya nggak akan bahas caranya. Tapi pelajaran buat kita yang menjalankan AI agent di VPS dan jaringan sendiri cukup jelas:
Refusal model itu bukan security boundary.
Apa itu abliterated model?
Model chat modern dilatih untuk dua hal: nurut instruksi, dan menolak permintaan berbahaya. Selama ini banyak orang menganggap "menolak" itu semacam lapisan pengaman yang tebal.
Riset Arditi dkk. (2024), "Refusal in Language Models Is Mediated by a Single Direction" menunjukkan hal yang bikin nggak nyaman. Di 13 model chat open-source populer sampai ukuran 72B, perilaku menolak itu ternyata dikendalikan oleh satu arah di ruang aktivasi model.
Hapus arah itu, model berhenti menolak. Tambahkan arah itu, model malah menolak permintaan yang aman.
Para peneliti lalu mengubahnya jadi modifikasi bobot permanen (weight orthogonalization). Maxime Labonne kemudian mempopulerkan istilah abliteration lewat tulisannya di Hugging Face, yang ia sebut bisa "uncensor" model tanpa retraining.
Singkatnya:
- Nggak perlu dataset jawaban berbahaya.
- Nggak perlu fine-tuning mahal.
- Cukup akses ke bobot model.
Paper yang sama mencatat jailbreak model 70B dengan cara ini butuh compute kurang dari $5. Itu angka dari penelitinya sendiri, bukan hiperbola saya.
Seberapa efektif? Lihat angkanya
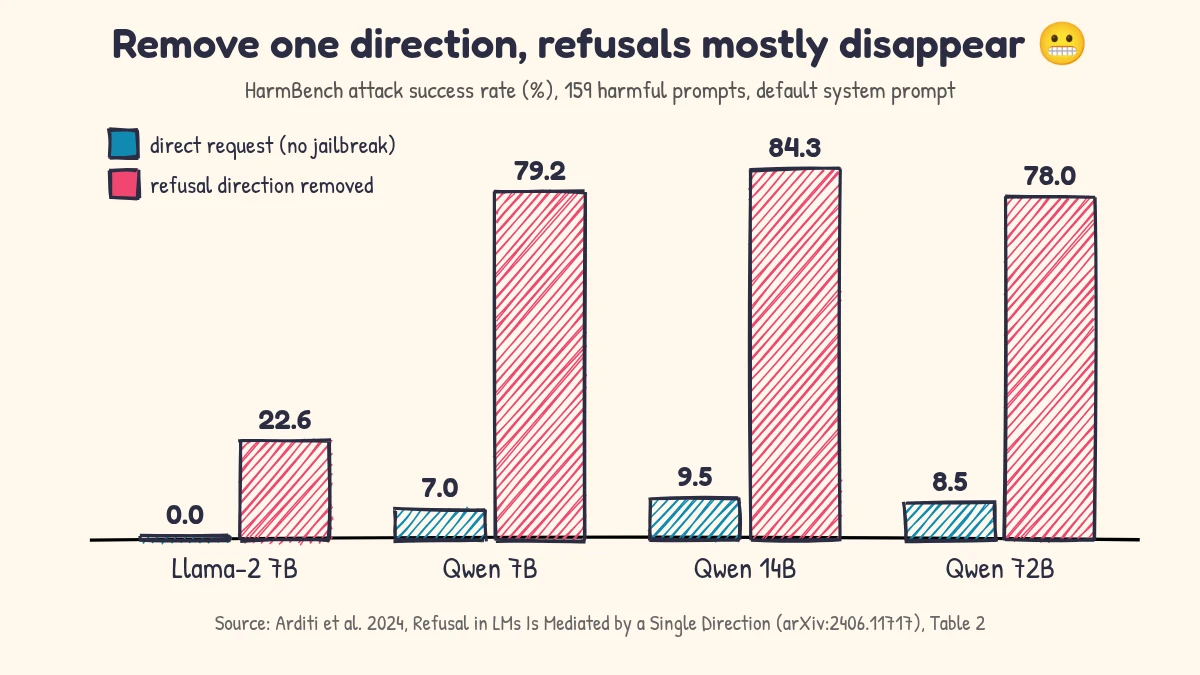
Data di atas dari Tabel 2 paper Arditi dkk., diuji dengan 159 perilaku berbahaya standar di HarmBench, memakai system prompt default model:
Llama-2 terlihat lebih tahan, tapi ada catatan: tanpa system prompt, angka Llama-2 7B naik ke 79,9%. Penyerang yang pegang bobot model tentu bebas membuang system prompt.
Yang lebih penting lagi: kemampuan modelnya nyaris nggak rusak. Di benchmark seperti MMLU, ARC, dan GSM8K, model yang sudah diorthogonalisasi skornya mirip model asli. Penurunan yang konsisten cuma di TruthfulQA.
Artinya penyerang dapat model yang sama pintarnya, minus rem.
Lesson: Kalau model open-weight bisa didownload, anggap versi tanpa rem-nya juga sudah ada.
Kenapa ini relevan buat kita yang bukan peneliti AI?
Karena peta ancamannya berubah.
Dulu, serangan otomatis ke jaringan butuh orang yang paham tool, paham exploit, dan sabar. Sekarang ada model yang nggak menolak, bisa jalan dalam loop agent, dan nggak capek mencoba.
Di videonya, Rasmic juga punya segmen soal perusahaan yang mulai kewalahan. Itu klaim dia, tapi logikanya masuk akal: biaya mencoba serangan turun, jadi jumlah percobaan naik.
Coba cek perangkat di rumah atau kantormu:
- Smart TV, CCTV, router bawaan ISP.
- Printer jaringan, NAS, mesin absensi.
- VPS yang jalanin bot, panel admin, dashboard monitoring.
Banyak yang firmware-nya jarang diupdate, password default-nya belum diganti, dan nyampur satu jaringan dengan laptop kerja. Dulu itu "risiko kecil karena siapa juga yang mau repot". Sekarang yang repot bisa saja sebuah agent.
Dua sisi koin: agent kita sendiri
Ada sisi kedua yang sering kelewat. Ini bukan cuma soal penyerang.
Banyak dari kita (termasuk saya) bikin AI agent dengan asumsi diam-diam: "Kalau ada instruksi aneh, model pasti menolak." Itu asumsi yang rapuh.
Model bisa diganti provider. Model bisa kena prompt injection lewat dokumen atau tool. Dan sekarang ada model uncensored yang gampang dicoba di layanan inference. Kalau suatu hari agent kamu jalan di atas model yang nggak punya rem, apa yang masih menahan dia?
Kalau jawabannya "nggak ada", desainnya yang salah, bukan modelnya.
Ini benang merah yang sama dengan MCP tool poisoning dan agentic wallet: pagar harus ada di sistem, bukan di niat baik model.
Di mana guardrail yang beneran?
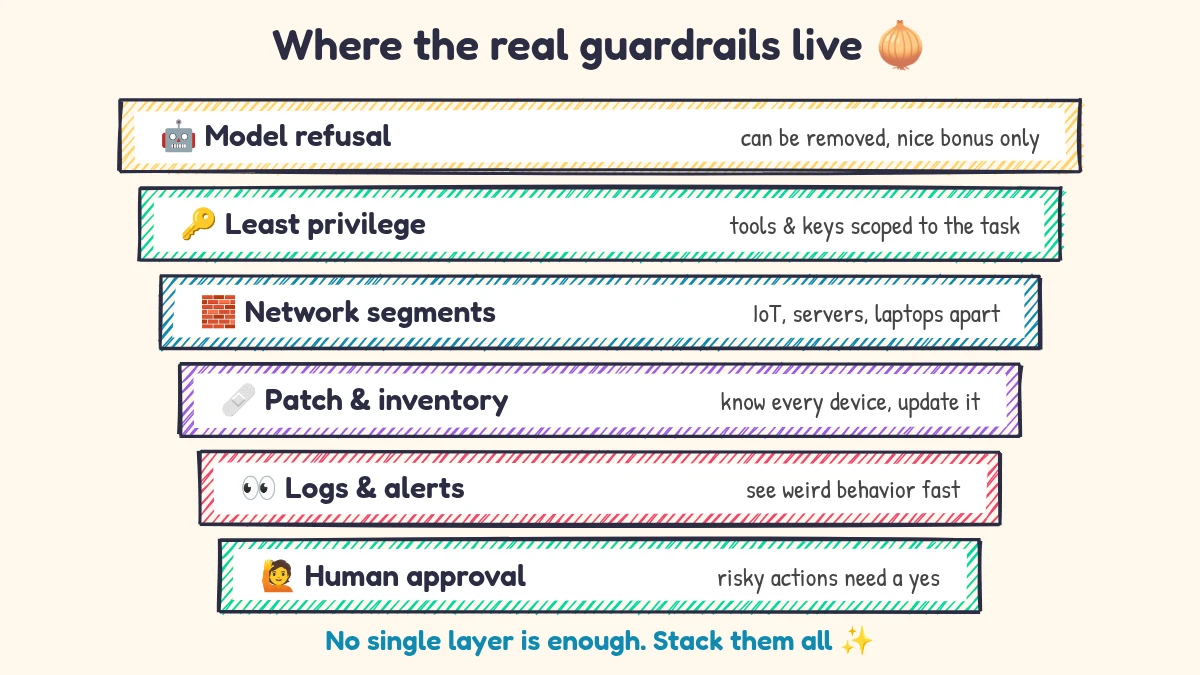
Ini checklist yang saya pakai sendiri. Nggak ada yang canggih, justru itu intinya.
1. Anggap refusal model cuma bonus
Refusal itu bagus untuk mencegah salah pakai yang nggak disengaja. Tapi jangan jadikan satu-satunya kontrol. Semua aksi berisiko harus dibatasi di level tool dan izin.
2. Least privilege untuk setiap agent
Agent yang tugasnya bikin draft artikel nggak perlu akses SSH. Agent yang baca email nggak perlu bisa transfer uang. OWASP menyebut masalah ini Excessive Agency (LLM06:2025): agent diberi fungsi, izin, atau otonomi lebih dari yang dibutuhkan.
Saya sudah bahas pola izinnya di MCP dan ERP: siapa pegang kunci.
3. Pisahkan jaringan
Perangkat IoT jangan satu segmen dengan server dan laptop kerja. Pakai VLAN atau minimal jaringan tamu terpisah untuk TV, CCTV, dan gadget rumah. Kalau satu perangkat jebol, jangan sampai jadi jembatan ke semuanya.
4. Inventaris dan patch
Kamu nggak bisa melindungi perangkat yang kamu nggak tahu ada. Bikin daftar sederhana: perangkat apa, firmware versi berapa, kapan terakhir update. Ganti semua password default.
Untuk VPS, pakai dasar yang sama seperti di checklist hardening OpenClaw: tutup port yang nggak perlu, matikan login password SSH, update rutin.
5. Log dan alert yang masuk akal
Serangan berbasis agent cenderung "berisik": banyak percobaan, banyak scan. Pastikan ada log yang dibaca dan alert yang sampai ke kamu, tanpa bikin alarm fatigue.
6. Human approval untuk aksi berisiko
Hapus data, kirim uang, ubah konfigurasi produksi, kirim pesan atas nama kamu: semua harus lewat persetujuan manusia. Model tanpa rem tetap nggak bisa lewat kalau tombolnya ada di tanganmu.
Dan jangan lupa audit agent kamu secara berkala. Agent bisa drift pelan-pelan, termasuk izinnya.
Bisa juga dipakai untuk bertahan
Satu hal yang fair untuk disebut: tim keamanan juga memakai model seperti ini untuk red teaming. Rasmic punya segmen khusus soal bagaimana perusahaan bisa memakainya untuk pertahanan.
Kalau kamu mau mencoba, aturannya cuma satu: hanya ke sistem milikmu sendiri, di lingkungan terisolasi, dengan izin tertulis kalau itu milik kantor. Menguji sistem orang lain tanpa izin itu tindak pidana, dan "saya cuma penasaran" bukan pembelaan.
Penutup
Abliteration membuktikan satu hal yang sebenarnya sudah lama jadi prinsip security: jangan percaya kontrol yang bisa dimatikan oleh pihak yang mau kamu tahan.
Model yang menolak itu bagus. Sistem yang tetap aman walau modelnya nggak menolak, itu yang kita butuhkan.
FAQ
Apa bedanya abliterated model dengan jailbreak biasa?
Jailbreak biasa memanipulasi prompt supaya model mau menjawab. Abliteration mengubah bobot model sehingga perilaku menolaknya hilang permanen, tanpa trik prompt.
Apakah model closed-source seperti GPT atau Claude bisa di-abliterate?
Teknik ini butuh akses ke bobot model (white-box). Paper Arditi dkk. menguji model open-source, dan penulisnya menyebut temuan mereka mungkin tidak berlaku untuk model yang belum diuji, termasuk model proprietary.
Apakah abliteration merusak kecerdasan model?
Menurut paper tersebut, efeknya kecil di benchmark umum seperti MMLU, ARC, dan GSM8K. Penurunan yang konsisten terlihat di TruthfulQA.
Apakah saya harus berhenti pakai model open-weight?
Nggak. Model open-weight tetap berguna. Yang perlu diubah adalah asumsi: jangan bergantung pada refusal model sebagai pengaman, dan pasang kontrol di izin, jaringan, dan approval.
Langkah paling cepat yang bisa saya lakukan hari ini?
Ganti password default perangkat jaringan, pisahkan perangkat IoT ke jaringan tamu, dan cek izin setiap AI agent yang kamu jalankan. Tiga hal itu bisa selesai dalam satu sore.
← Artikel Sebelumnya
AI Sales Team 13 Agent: Boleh Kerja Keras, Tapi Jangan Kirim Sendiri
Artikel Selanjutnya →
Notes App untuk AI Agent: Pilih yang Datanya Bisa Kamu Bawa Pergi
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.