
Always-On Agent Itu Bukan Nyala 24 Jam: 5 Komponen yang Bikin Beres

Banyak orang bayangin "always-on agent" itu satu proses AI yang nyala terus, nongkrong di server, mantengin semua hal 24 jam.
Kalau kamu bangun agent dengan bayangan itu, hasilnya biasanya dua: tagihan bengkak, atau agent yang diam-diam mati dan nggak ada yang sadar.
Anthropic baru saja menerbitkan panduan Building always-on agents dan kalimat pembukanya langsung meluruskan ini: always-on agent sebenarnya tidak selalu nyala. "Always-on" itu cuma deskripsi pengalaman user. Di balik layar, agent lebih banyak tidur.
Saya setuju banget. Bot-bot yang saya jalankan di VPS juga begitu: bangun karena jadwal atau event, kerja sebentar, catat hasilnya, lalu tidur lagi. Yang bikin dia terasa "selalu ada" bukan modelnya, tapi arsitektur di sekelilingnya.
Polanya: tidur, bangun, kerja, catat, tidur lagi
Panduan itu memakai dua istilah yang menurut saya wajib kamu pakai juga:
- Run: satu potong kerja. Agent menerima event, menyelesaikan tugas, lalu menyimpan apa yang terjadi.
- Session: transkrip pesan dan tool call tempat run itu berjalan.
Setelah run selesai, agent tidur. Siklusnya berulang tanpa batas.
Kenapa ini penting? Karena begitu kamu mikir dalam satuan "run", pertanyaan desainnya berubah. Bukan lagi "gimana agent ini tetap hidup?", tapi "apa yang membangunkan dia, apa yang dia bawa dari run sebelumnya, dan gimana hasilnya sampai ke saya?"
Anthropic juga menyebut alasan pola ini makin masuk akal sekarang: model makin pintar menilai kapan harus lapor, dan biaya kecerdasan turun. Contoh yang mereka kasih, di satu benchmark coding jangka panjang, Opus 5.5 butuh biaya per task yang berhasil 78% lebih rendah dibanding Opus 5, sementara di workload biasa turunnya 40%. Itu angka mereka, bukan hasil tes saya, tapi arahnya jelas: kerja panjang yang dipecah jadi banyak run makin terjangkau.
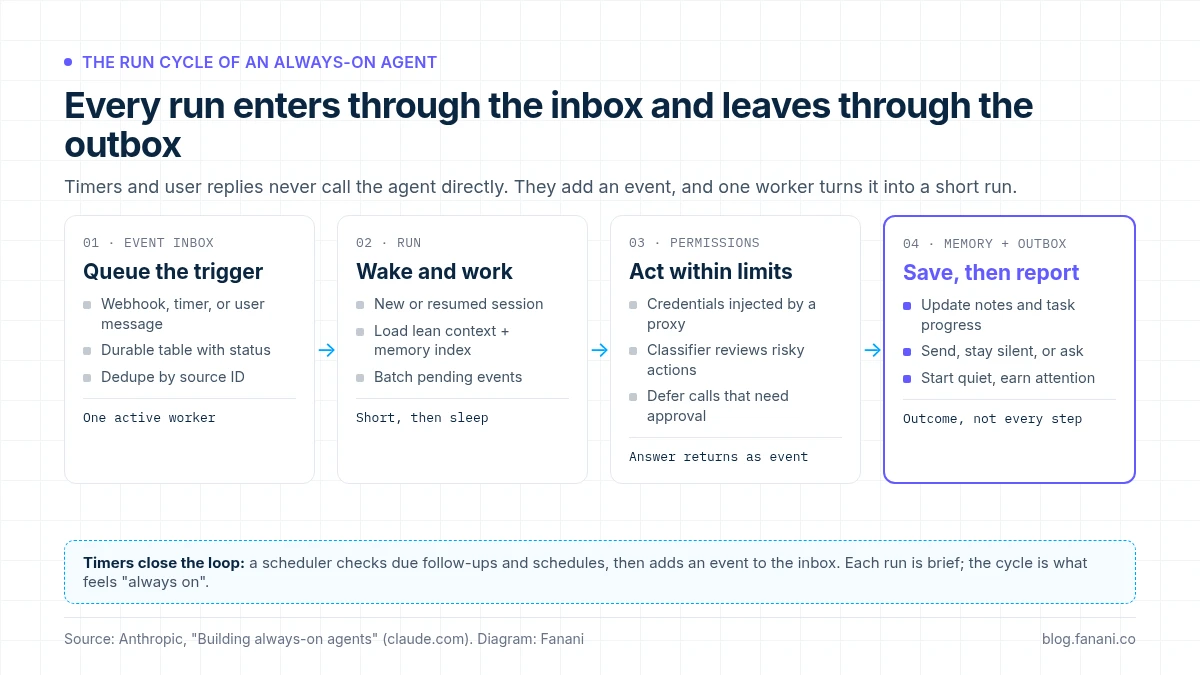
5 komponen yang bikin agent terasa "selalu ada"
Panduannya merumuskan lima primitive: event inbox, timers, memory, permissions, outbox. Saya bahas satu-satu, plus opini saya soal mana yang paling sering dilupakan.
1. Event inbox: jangan biarkan semua sumber manggil agent langsung
Godaan pertama waktu bikin agent: webhook masuk, langsung panggil agent. Pesan Telegram masuk, langsung panggil agent. Cron jalan, langsung panggil agent.
Masalahnya, dua event yang datang barengan bisa bikin dua run yang saling tabrakan. Dan kalau proses crash, event-nya hilang begitu saja.
Solusinya: semua sumber menulis ke inbox, lalu satu worker yang mengambil dari sana. Versi paling sederhana cuma tiga komponen:
- List event yang durable, biasanya tabel database.
- Handler, biasanya HTTP endpoint, yang menulis event ke list itu.
- Worker, biasanya background service, yang membaca list itu.
Aturan main dari panduan yang menurut saya paling krusial:
- Handler harus cepat acknowledge. Webhook provider sering menganggap respons lambat sebagai gagal. Pemeriksaan berat, termasuk cek prompt injection, dilakukan di dalam run, bukan di handler.
- Inbox adalah source of truth. Kalau worker mati di tengah jalan, worker baru tinggal ambil event yang sama dan coba lagi.
- Satu inbox, satu worker aktif. Biar nggak ada dua run yang kerja dobel atau saling timpa.
- Batch event yang pending. User kirim lima pesan beruntun? Gabung jadi satu run, balas sekali.
Event juga bisa di-dedupe pakai ID unik dari sumbernya. Ini kecil tapi menyelamatkan kamu dari agent yang membalas webhook yang sama tiga kali.
Lesson: agent yang dipanggil langsung oleh semua sumber itu bukan always-on, itu race condition yang menunggu waktu.
2. Timers: bedakan follow-up dan schedule
Inbox bikin agent reaktif. Timers bikin dia proaktif.
Ada dua jenis:
- Follow-up: deadline yang dipasang agent untuk dirinya sendiri. Misalnya "cek lagi besok jam 9 apakah klien sudah balas."
- Schedule: tugas berulang dengan ritme jelas. Misalnya laporan harian.
Detail desain yang saya suka: timer tidak memulai run sendiri. Scheduler mengecek tabel timer secara berkala, menandai follow-up yang jatuh tempo sebagai selesai, memajukan schedule ke jadwal berikutnya, lalu memasukkan event ke inbox. Jadi semua jalan masuk tetap lewat satu pintu.
Kalau kamu sudah pakai cron di VPS, ini evolusi yang wajar. Cron tetap boleh jadi "jam"-nya, tapi jangan biarkan cron langsung mengeksekusi logika agent. Biar cron cukup menaruh event. Soal cron yang sehat, saya pernah tulis di 3 Cron Job Wajib untuk Agentic AI di VPS.
3. Memory: simpan yang nggak bisa dicari lagi
Run itu terputus-putus. Tanpa memory, setiap run mulai dari nol.
Prinsip dari panduan ini yang menurut saya paling berharga: memory cuma menyimpan apa yang nggak bisa agent cari lagi. Kalau datanya sudah ada di sistem lain, misalnya issue tracker, simpan pointer-nya saja.
Jenis memory yang mereka sarankan:
- User instructions: aturan perilaku dari user, dimuat di awal setiap run. User nggak selalu ada untuk mengarahkan, jadi aturannya harus ikut terbawa.
- User notes: yang agent pelajari soal user, seperti peran, preferensi, koreksi.
- Past messages: apa yang sudah disampaikan ke user, supaya nggak mengulang.
- Task progress: file progres per tugas, berisi apa yang sudah dan belum. Run berikutnya tinggal lanjut.
Untuk catatan yang tumbuh besar, yang dimuat di awal run cukup index-nya. Detailnya ditarik kalau perlu.
Ini nyambung dengan soal biaya. Setiap run membawa "overhead" yang sama: system prompt, definisi tool, file memory. Panduan itu menyarankan overhead ini dijaga ramping dan memakai prompt caching. Kalau session kepanjangan, kamu bisa compact atau mulai session baru, tapi dua-duanya kehilangan detail. Jadi apa pun yang harus bertahan, tulis ke memory selama run berjalan. Trade-off compaction ini saya bahas di Auto-Compact 400K di Claude Code.
Lesson: memory yang isinya salinan data dari sistem lain cuma bikin dua sumber kebenaran yang lama-lama nggak sinkron.
4. Permissions: tempat risiko terbesar
Ini bagian yang paling sering diremehkan, padahal panduannya sendiri bilang permissions adalah tempat always-on agent membawa risiko paling besar. Masuk akal: run memegang akses user dan, by design, jalan tanpa diawasi.
Tiga komponen yang mereka sebut:
- Credential store lewat proxy. Agent mengirim request tanpa kredensial, proxy di luar environment agent yang menyuntikkan kredensial asli. Jadi token nggak pernah nongkrong di context agent.
- Auto mode. Classifier meninjau aksi berisiko tinggi dan memblokir yang berbahaya, supaya agent cari jalan yang lebih aman. Tapi keputusan paling penting tetap butuh review user.
- Deferred tool call. Kalau agent butuh izin, run berhenti dan session disimpan di tengah tool call. Permintaan ditampilkan ke user, jawabannya masuk sebagai event baru di inbox, lalu run baru melanjutkan session itu. Sementara menunggu, worker bisa mengerjakan event lain.
Pola deferred tool call ini menurut saya jawaban paling rapi untuk dilema klasik: agent yang terlalu sering minta izin itu menyebalkan, agent yang nggak pernah minta izin itu berbahaya. Dengan defer, agent nggak macet nunggu jawaban, dan kamu tetap pegang rem untuk aksi yang nggak bisa ditarik.
Kalau kamu belum punya pagar sama sekali, mulai dari daftar aksi yang wajib approval: kirim pesan ke orang lain, hapus data, bayar sesuatu. Sisanya boleh otomatis. Saya juga pernah membahas sisi "AI yang datang duluan" ini di Claude Duet: AI Datang Duluan, Bukan Nunggu Disuruh.
5. Outbox: lebih baik mulai pendiam
Agent biasa streaming jawabannya ke user. Always-on agent kerja di belakang, jadi user cukup dapat hasil dan sedikit detail, bukan seluruh langkah.
Satu run bisa berakhir dengan tiga cara:
- Agent mengirim pesan ke outbox.
- Agent memutuskan nggak ada yang perlu dikirim.
- Agent memakai deferred tool call untuk minta izin atau input.
Poin kedua itu penting dan sering dilupakan. "Nggak kirim apa-apa" adalah hasil yang valid.
Kebanyakan agent cukup dengan tool "send" sederhana. Outbox formal, yaitu tabel pesan keluar plus dispatcher, baru perlu kalau kamu mau mengatur ritme pesan atau bisa pulih dari error pengiriman.
Saran mereka yang paling saya setujui: agent sebaiknya mulai pendiam, lalu pelan-pelan "mendapatkan" perhatian user. Agent yang kebanyakan lapor jadi noise. Agent yang terlalu jarang lapor bikin kamu kelewatan hal penting. Cara menemukan titik tengahnya: bikin eval, bukan feeling.
Lesson: agent yang lapor "semua aman" tiap jam itu bukan rajin, itu alarm fatigue yang dicicil.
Cara saya mulai kalau bangun dari nol
Kalau saya mulai always-on agent baru hari ini, urutannya begini:
- Satu tabel inbox dengan status (pending, running, done) dan kolom ID sumber untuk dedupe.
- Satu worker yang selalu ambil dari inbox dulu, bukan dari payload yang dioper langsung.
- Satu tabel timer, scheduler-nya cuma menaruh event ke inbox.
- Folder memory berisi instruksi user, catatan, dan file progres per tugas, dengan index kecil yang dimuat tiap run.
- Daftar aksi wajib approval, dan kredensial tidak pernah masuk ke prompt.
- Tool send biasa dulu. Outbox formal menyusul kalau pesan mulai terlalu ramai atau butuh retry.
Skemanya kira-kira seperti ini:
-- inbox: satu-satunya pintu masuk run
CREATE TABLE events (
  id INTEGER PRIMARY KEY,
  source TEXT NOT NULL,        -- 'webhook', 'timer', 'user'
  source_id TEXT NOT NULL,     -- untuk dedupe
  payload TEXT,
  status TEXT DEFAULT 'pending',
  UNIQUE (source, source_id)
);

-- timers: follow-up dan schedule
CREATE TABLE timers (
  id INTEGER PRIMARY KEY,
  kind TEXT NOT NULL,          -- 'followup' atau 'schedule'
  due_at TEXT NOT NULL,
  recurrence TEXT,             -- hanya untuk schedule
  done INTEGER DEFAULT 0
);
Itu contoh skema minimal versi saya, bukan kode resmi dari panduan Anthropic. Sesuaikan dengan stack kamu.
Yang sengaja saya tunda: "dreaming", yaitu proses yang meninjau session lama untuk merapikan memory dan menemukan pola. Panduannya menyebut ini sebagai tambahan opsional. Menurut saya, jangan dikerjakan sebelum lima komponen dasar stabil. Memory yang belum disiplin kalau dirapikan otomatis cuma jadi berantakan yang lebih cepat.
Satu lagi: run yang bisa diulang dengan aman itu wajib. Worker bisa mati, event bisa diambil ulang. Kalau langkahmu belum idempotent, retry malah bikin kerja dobel. Soal mengubah kesalahan jadi pagar permanen, lihat AI Agent Jangan Salah Dua Kali.
Penutup
Always-on agent yang bagus itu bukan yang nyala terus. Yang bagus itu yang bangun di saat tepat, ingat yang perlu, minta izin untuk hal yang berisiko, dan diam kalau nggak ada yang penting.
Lima komponen ini kedengarannya seperti infrastruktur yang membosankan. Memang. Tapi justru di situ bedanya agent demo dengan agent yang bisa kamu percaya jalan sendirian selama berbulan-bulan.
FAQ
Apakah always-on agent harus jalan 24 jam di server?
Nggak. Menurut panduan Anthropic, agent lebih banyak tidur dan bangun untuk run singkat ketika ada event atau timer. Yang jalan terus cuma komponen ringan seperti handler, worker, dan scheduler.
Apa bedanya event inbox dengan langsung memanggil agent dari webhook?
Inbox menyimpan event secara durable, bisa dedupe, dan memastikan cuma satu worker aktif. Kalau dipanggil langsung, event bisa hilang saat crash dan dua run bisa saling tabrakan.
Apa yang sebaiknya disimpan di memory agent?
Hanya yang nggak bisa dicari lagi: instruksi user, catatan soal user, pesan yang sudah dikirim, dan progres tugas. Data yang sudah ada di sistem lain cukup disimpan pointer-nya.
Bagaimana always-on agent minta izin tanpa macet?
Pakai deferred tool call: run berhenti, session disimpan, permintaan ditampilkan ke user, dan jawabannya masuk sebagai event baru yang melanjutkan session. Selama menunggu, worker bisa mengerjakan event lain.
Kapan butuh outbox formal?
Kalau kamu perlu mengatur ritme pesan atau ingin pengiriman bisa pulih dari error. Untuk kebanyakan agent, tool "send" sederhana sudah cukup.
Referensi: Building always-on agents (Anthropic, ditulis William Hu); ringkasan diskusi di X @TekonBurns.
← Artikel Sebelumnya
"Bikin Modern" Bukan Brief: Prompt UI/UX yang Bisa Dicek AI Agent
Artikel Selanjutnya →
ASD-STE100 untuk AI: Pakai Versi 80%, Jangan yang Strict
Baca Juga



Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.