
AI Agent Jangan Salah Dua Kali: Ubah Setiap Error Jadi Pagar
AI agent kamu salah lagi. Kesalahan yang sama, minggu lalu juga begitu.
Reaksi pertama biasanya nambah satu baris di prompt: "IMPORTANT: selalu jalankan test sebelum bilang selesai." Seminggu aman. Lalu context makin panjang, task makin rumit, model diganti, dan baris itu tenggelam. Kesalahan lama balik lagi, cuma beda baju.
Masalahnya bukan agent-nya bandel. Bobot model itu beku. Bug report kamu nggak pernah sampai ke sana. Satu-satunya bagian sistem yang bisa belajar dari kesalahan adalah harness: instruksi, tool, hook, dan aturan di sekeliling model.
Jadi pertanyaannya bukan "prompt apa yang harus saya tulis?", tapi "kesalahan ini harus dipasangi pagar di mana, supaya nggak perlu diingatkan lagi?"
Definisi yang paling berguna: harness itu kata kerja
Mitchell Hashimoto (co-founder HashiCorp, pembuat Ghostty) menulis definisi yang menurut saya paling praktis di esainya My AI Adoption Journey:
"anytime you find an agent makes a mistake, you take the time to engineer a solution such that the agent never makes that mistake again."
Perhatikan, ini bukan daftar komponen. Ini kebiasaan. Setiap kali agent salah, kamu investasi waktu supaya kesalahan itu nggak bisa terulang.
Hashimoto menyebut dua bentuk: memperbaiki AGENTS.md untuk hal sederhana (agent salah command, salah API), dan bikin tool beneran seperti script screenshot atau test yang difilter, ketika masalahnya lebih dari sekadar lupa.
Addy Osmani menyebut pola ini ratchet: constraint ditambah hanya setelah ada kegagalan nyata, dan dicabut hanya kalau model yang lebih kuat sudah bikin constraint itu nggak perlu. Setiap baris di AGENTS.md yang bagus harus bisa dilacak ke satu kesalahan spesifik.
Saya sudah pernah bahas kenapa harness sama pentingnya dengan model. Artikel ini fokus ke sisi operasionalnya: gimana caranya setiap kesalahan benar-benar jadi pelajaran permanen.
Bukti bahwa ini bukan teori
LangChain punya contoh yang enak dipelajari. Di tulisan Improving Deep Agents with harness engineering (17 Feb 2026), mereka menaikkan skor coding agent mereka di Terminal Bench 2.0 dari 52,8% ke 66,5%. Modelnya tetap gpt-5.2-codex. Yang diubah cuma harness.
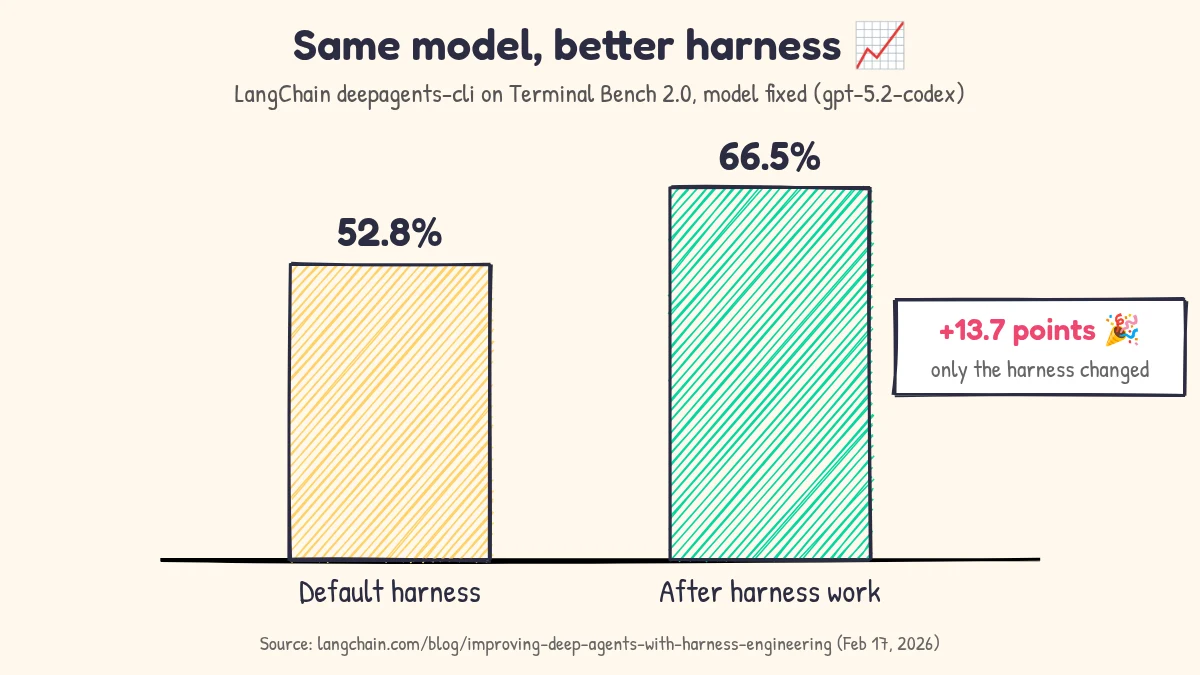
Yang menarik bukan angkanya, tapi cara mereka menemukan perbaikannya. Kegagalan paling sering: agent menulis solusi, membaca ulang kodenya sendiri, merasa sudah oke, lalu berhenti. Nggak ada test, nggak ada run.
Solusinya bukan model yang lebih pintar. Mereka pasang PreCompletionChecklistMiddleware yang mencegat agent sebelum keluar dan memaksa satu putaran verifikasi terhadap spec task. Ditambah loop detection yang menyuruh agent mundur dan pikir ulang kalau sudah terlalu sering mengedit file yang sama.
Anthropic menemukan pola serupa di Effective harnesses for long-running agents. Claude cenderung menandai fitur selesai tanpa test end-to-end. Begitu diberi browser automation dan diminta menguji seperti user sungguhan, performanya "dramatically improved".
Lesson: kalau kesalahannya bisa ditebak, perbaikannya bisa diotomatisasi.
Kenapa fix di prompt cepat basi
Ada tiga tempat untuk menaruh perbaikan, dan kekuatannya beda jauh:
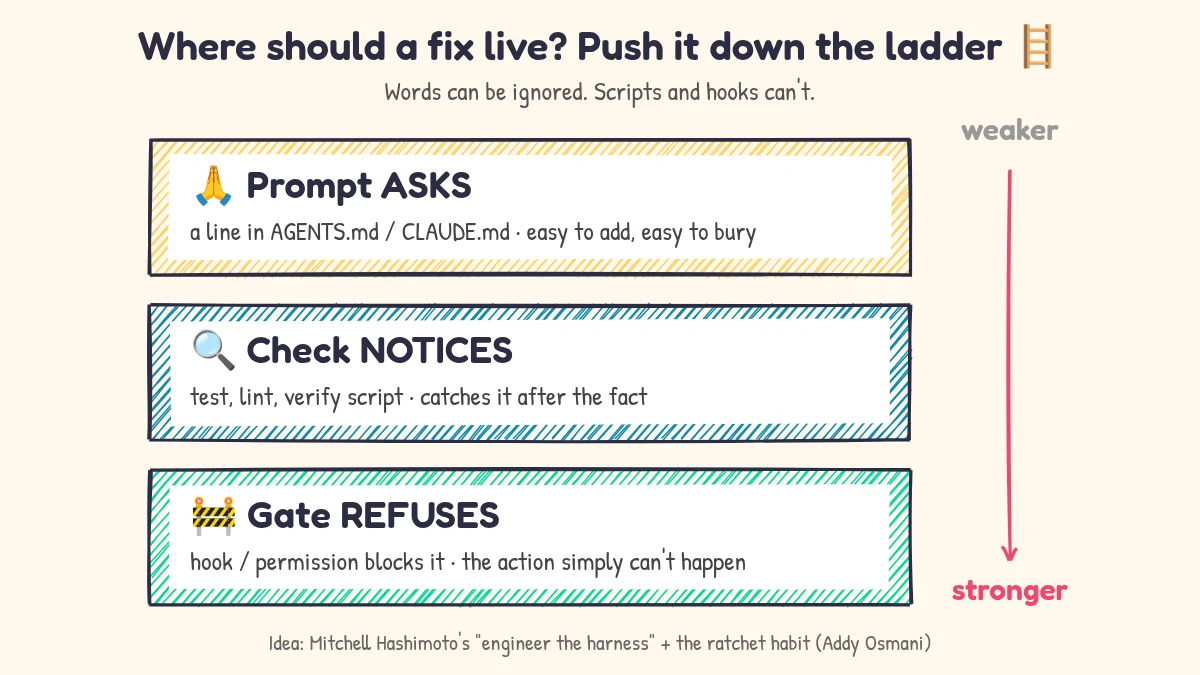
- Prompt meminta. Satu baris di
AGENTS.mdatauCLAUDE.md. Gampang ditambah, gampang juga tenggelam. - Check mendeteksi. Test, lint, atau script
verify.shyang dijalankan sebelum task dianggap selesai. Kesalahan tetap bisa terjadi, tapi ketahuan. - Gate menolak. Hook atau permission yang bikin aksi itu memang nggak bisa dilakukan. Agent nggak perlu ingat, karena pintunya sudah dikunci.
Contoh bagus dari tulisan Anthropic tadi: daftar fitur mereka harus bertahan ratusan sesi tanpa diubah diam-diam oleh agent. Jadi mereka simpan dalam JSON, bukan Markdown, karena model lebih jarang mengubah JSON secara sembarangan. Agent cuma boleh mengganti satu field, passes. Dan ada instruksi tegas bahwa menghapus atau mengedit test itu tidak bisa diterima.
Mereka nggak cuma minta agent berperilaku baik. Mereka mengubah bentuk lingkungannya supaya perilaku buruk lebih susah terjadi.
Aturan praktis saya: taruh setiap fix serendah mungkin di tangga itu. Kalau bisa jadi gate, jangan berhenti di prompt.
Failure ledger: satu file, satu baris per kesalahan
Model lupa. File nggak.
Ide ini saya ambil dari field manual harness engineering yang menyebutnya failure ledger: satu file yang mencatat setiap kegagalan agent, disimpan di repo atau folder kerja bot. Bentuknya bisa sesederhana ini:
## 2026-11-03 — agent bilang "selesai" tanpa build
- Gejala: PR lolos review, build CI merah
- Kelas: overconfident
- Fix: Stop hook jalankan verify.sh (gate)
- Bukti guard bekerja: replay task lama, hook menolak ✅
- Status: aktif
Kenapa repot dicatat? Karena tanpa catatan, "agent-nya flaky" itu cuma perasaan. Dengan ledger, kamu bisa lihat kelas kesalahan mana yang terus balik, dan fix mana yang ternyata nggak mempan.
Ledger juga bukan cuma untuk coding agent. Bot yang bikin draft email, menyusun laporan, atau update CRM juga punya kesalahan berulang: salah format tanggal, lupa lampiran, pakai template lama. Polanya sama.
Loop ratchet dalam lima langkah
Ini loop yang saya pakai sebagai patokan:
- Tangkap. Kesalahan terjadi, catat di ledger lengkap dengan gejalanya.
- Namai. Overconfident (klaim selesai tanpa bukti), stuck (muter di tempat), amnesia (lupa konteks sesi lalu), atau reckless (aksi berbahaya). Nama yang jelas bikin fix-nya jelas.
- Turunkan. Pilih tempat fix satu tingkat lebih rendah dari insting pertama. Insting bilang "tambah di prompt"? Coba bikin check.
- Buktikan. Replay kesalahan aslinya dan pastikan guard benar-benar menangkapnya. Ini langkah yang paling sering dilewati. Guard yang belum pernah terbukti menangkap apa pun cuma harapan dengan nama file.
- Kunci. Commit. Ratchet maju satu klik.
Satu aturan keamanan yang wajib: agent boleh mengetatkan harness-nya sendiri, tapi hanya manusia yang boleh melonggarkan. Agent yang bisa menghapus Stop hook-nya sendiri sebenarnya nggak punya harness. Dia cuma punya saran. Ini nyambung dengan kebiasaan audit rutin tim AI agent yang pernah saya tulis.
Jangan lupa katup pelepasnya
Ratchet yang cuma bisa mengencang lama-lama jadi beban. Setiap guard makan token, latency, dan perhatian. Model baru juga sering sudah nggak butuh guard yang dulu dibuat untuk model lama.
Makanya Osmani menekankan dua arah: tambah constraint karena ada kegagalan nyata, cabut constraint karena ada bukti model sudah mengatasinya. Bukan karena feeling.
Cara gampangnya: setiap kali ganti model, jalankan ulang test harness kamu dengan beberapa guard dimatikan. Kalau hasilnya tetap bagus, guard itu bisa pensiun. Kalau rusak, berarti guard-nya masih kerja.
Mulai minggu ini
Nggak perlu platform khusus. Cukup:
- Satu file
failure-ledger.mddi folder kerja agent. - Isi dengan tiga kesalahan terakhir yang kamu ingat.
- Untuk masing-masing, tentukan fix satu tingkat lebih rendah dari rencana awal.
- Tulis
verify.shsederhana. Kalau kamu nggak bisa menulisnya, berarti definisi "selesai" untuk task itu memang belum jelas. - Jumat depan, hitung: berapa kesalahan di ledger yang terulang?
Kalau kamu sedang onboarding bot baru, gabungkan dengan cara onboard AI agent seperti anak magang: ledger itu catatan evaluasi yang nanti kamu baca bareng dia. Untuk tim yang banyak PR dari agent, lapisan code review ala tim Claude Code juga pas dijadikan gate.
Penutup
Prompt engineering bertanya: apa yang harus saya katakan ke model?
Harness engineering bertanya: apa yang seharusnya nggak perlu dikatakan lagi?
Model kamu tetap akan lupa di setiap sesi. Berhenti menulis surat yang makin panjang. Pasang pagar yang nggak bisa dia lupakan.
FAQ
Apa bedanya harness engineering dengan prompt engineering?
Prompt engineering mengubah apa yang dikatakan ke model. Harness engineering mengubah lingkungan di sekitar model: tool, test, hook, permission, dan file instruksi, supaya kesalahan tertentu nggak bisa terulang walaupun prompt-nya berubah.
Apa itu failure ledger?
File sederhana berisi satu entri per kesalahan agent: gejala, kelas kesalahan, fix yang dipasang, dan bukti bahwa fix itu bekerja. Fungsinya mengubah "agent-nya suka error" jadi data yang bisa dianalisis.
Kapan cukup menambah baris di AGENTS.md?
Untuk hal ringan seperti command yang salah atau konvensi folder. Kalau kesalahannya mahal, berulang, atau berbahaya, naikkan ke check atau gate.
Boleh nggak agent memperbaiki harness-nya sendiri?
Boleh untuk mengusulkan dan mengetatkan, misalnya menambah test atau check. Melonggarkan atau menghapus guard harus lewat persetujuan manusia.
Apakah ini hanya untuk coding agent?
Nggak. Bot admin, bot laporan, atau bot sales juga punya kesalahan berulang. Polanya sama: catat, namai, pasang guard serendah mungkin, buktikan, kunci.
← Artikel Sebelumnya
Dari WordPress ke Astro: Situs Statis Lebih Ramah untuk AI Agent
Artikel Selanjutnya →
Tebar: Ngonten ke 10 Platform Cukup Lewat Chat sama AI
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.