
AI Coding Agent Bikin Kode Naik, Tapi Review Jadi Leher Botol
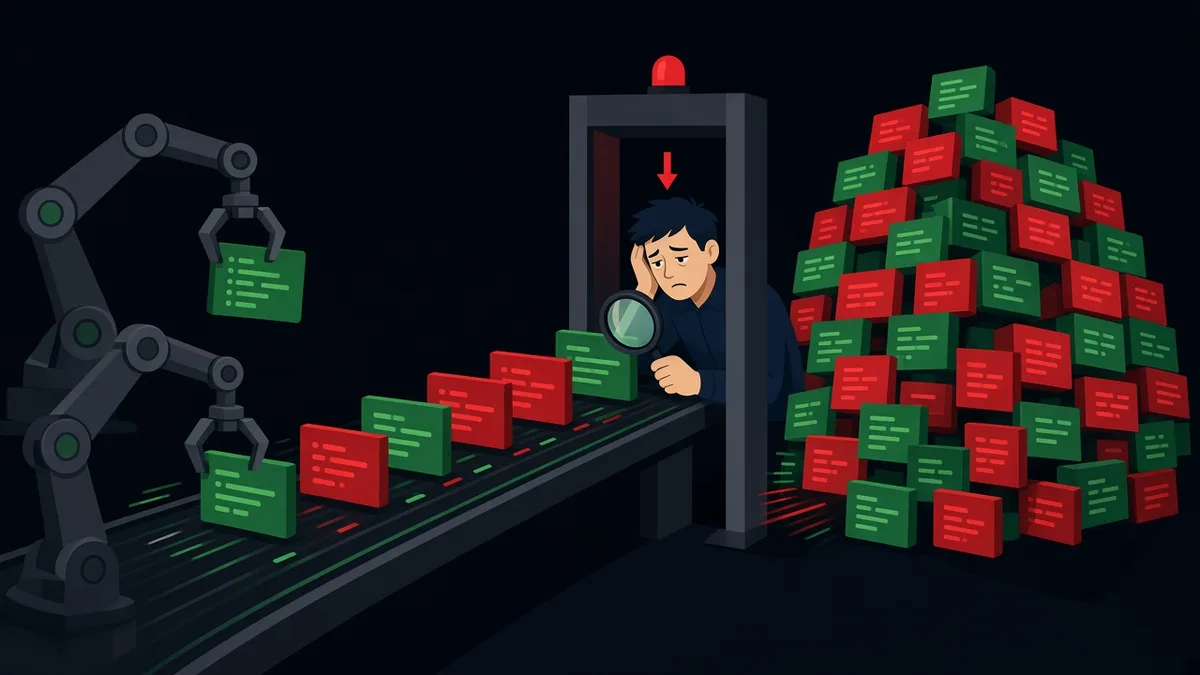
Coding agent sekarang bisa menulis kode lebih cepat dari kita membacanya.
Kedengarannya seperti kabar baik. Sampai kamu lihat antrean pull request yang menumpuk, reviewer yang kelelahan, dan fitur yang... tetap belum rilis.
Minggu ini satu riset dari Harvard ramai lagi di X: AI coding agent menaikkan output kode, tapi output software akhir nggak ikut naik sebanding. Bottleneck-nya pindah ke code review.
Saya rasa ini salah satu riset paling penting tahun ini untuk siapa pun yang memakai agent buat kerja, bukan cuma programmer.
Kenapa ini viral
X Trending sempat menampilkan cerita "AI Coding Agents Speed Up Output But Widen Verification Gap" (X trending). Banyak post mengutip angka "PR +23%, review time +49%", misalnya @EthanLinAI. Ada juga yang menulis dengan jujur: kode yang dihasilkan agent dalam 3 menit lalu dibaca sejam "like a suspicious landlord" (@rejaramadhan98).
Di Reddit, r/indiehackers membahas pertanyaan yang sama: "Are coding agents creating a review wall?"
Media juga ikut membahas: Ars Technica dan InfoQ.
Catatan penting: angkanya sudah direvisi
Ini bagian yang jarang dibahas di timeline.
Paper-nya adalah Artificial Intelligence in the Firm: Bottlenecks in Software Production oleh Fiona Chen dan James Stratton (Harvard), memakai data platform analitik engineering Jellyfish. Versi PDF terbaru bertanggal 31 Oktober 2026 mencakup 445 juta work event, 720.542 pekerja, di 655 perusahaan (Januari 2021 sampai Agustus 2026).
Angka yang viral (PR +23%, review +49%) berasal dari versi sebelumnya. Di versi terbaru, estimasinya berubah. Jadi kalau kamu mau mengutip, kutip versinya. Chart di bawah memakai versi 31 Oktober 2026.
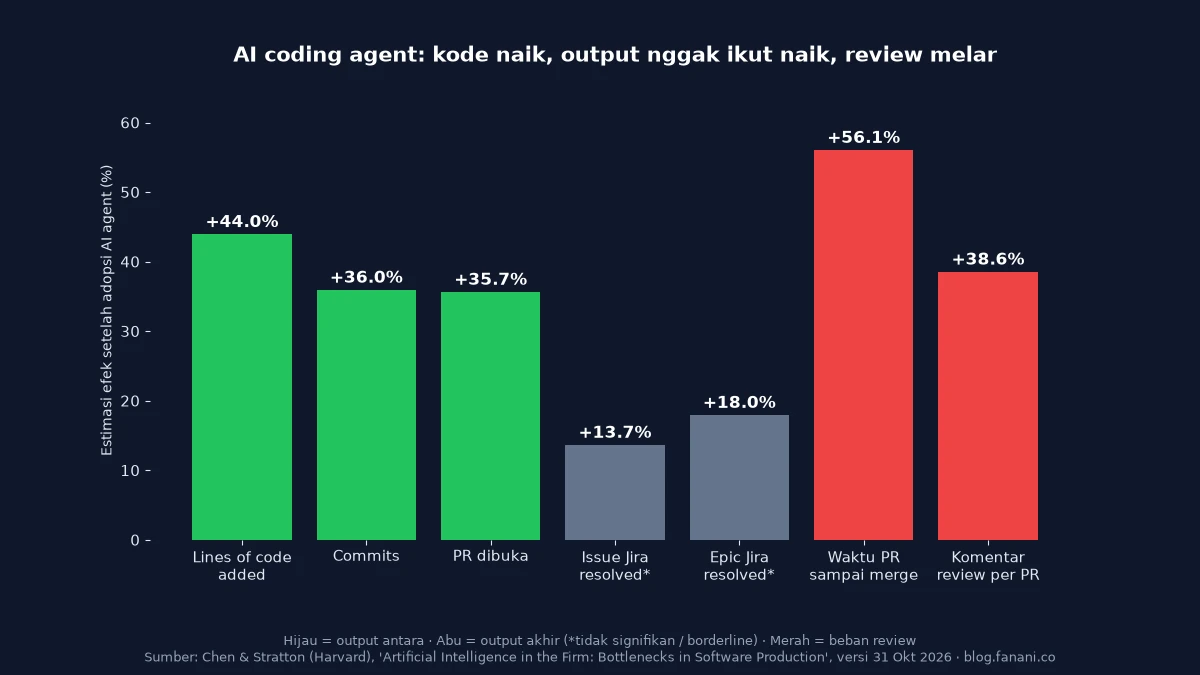
Ringkasan versi terbaru untuk AI agents:
Paper itu juga menyebut estimasinya menolak kenaikan output akhir lebih dari 30,7% dari baseline. Artinya: jauh di bawah kenaikan kode.
Lesson: menulis kode itu murah sekarang. Membuktikan kode itu benar yang mahal.
Kenapa bottleneck pindah ke review
Paper itu memberi penjelasan sederhana. Engineer cuma menghabiskan sekitar 30–40% waktunya untuk menulis kode. Sisanya untuk perencanaan, review, testing, dan koordinasi. Kalau AI cuma mempercepat bagian 30–40% itu, bagian lainnya jadi leher botol.
Dan ada temuan yang menurut saya paling tajam: review biasanya dilakukan engineer senior. Di data itu, senior mengerjakan 75,7% review untuk PR yang ditulis senior. Kamu nggak bisa memindahkan sembarang orang ke review karena review butuh pemahaman codebase.
Jadi agent menambah suplai kode, tapi kapasitas orang yang bisa menilai kode itu tetap sama.
Ini bukan cuma masalah programmer
Saya sering lihat pola yang sama di automation non-coding:
- Agent bikin 50 draft konten, tapi yang approve tetap satu orang.
- Agent bikin 20 laporan, tapi nggak ada yang sempat baca.
- Agent bikin 100 alert, tapi on-call cuma satu.
Polanya sama: produksi naik, verifikasi nggak. Hasilnya bukan produktivitas, tapi antrean. Saya pernah tulis versi ops-nya di Automation yang Belum Terbukti Manual Cuma Mempercepat Noise.
Di X juga ramai cerita senada: menjalankan banyak agent terasa seperti progres, tapi yang dihitung seharusnya fitur yang benar-benar rilis (X trending).
Yang saya lakukan: geser effort ke verifikasi
Ini opini dan pendekatan yang menurut saya masuk akal. Bukan resep pasti, tapi arah.
1. Batasi ukuran output agent, bukan cuma kualitasnya
Satu PR besar dari agent lebih mahal di-review daripada tiga PR kecil. Kasih aturan di instruksi agent:
## Aturan PR
- Maksimal 1 perubahan logis per PR.
- Sertakan: tujuan, file yang diubah, cara test, risiko.
- Kalau diff > 400 baris, pecah dulu.
Angka 400 itu batas pribadi, bukan dari paper. Sesuaikan dengan tim kamu.
2. Minta bukti, bukan klaim
Agent wajib menyertakan output test, screenshot, atau log. "Sudah saya cek" tanpa bukti = belum dicek.
3. Pakai AI untuk pre-review, tapi jangan berharap keajaiban
Ada catatan menarik di InfoQ: penulis paper tidak menemukan perbaikan dari adopsi AI untuk membantu review. Jadi AI reviewer boleh dipakai sebagai filter pertama, tapi jangan mengira dia otomatis menghapus bottleneck.
4. Ukur yang benar
Jangan ukur jumlah PR atau lines of code. Ukur:
- Lead time sampai production
- Jumlah issue yang benar-benar selesai
- Waktu tunggu di review
- Rework setelah merge
Kalau metrik kamu cuma "berapa banyak yang agent hasilkan", kamu sedang mengukur keramaian, bukan kemajuan. Saya bahas bedanya di Body Monitor vs Brain Monitor.
5. Lindungi waktu reviewer senior
Kalau reviewer adalah resource paling langka, perlakukan seperti resource paling langka. Batasi WIP. Jangan biarkan agent membanjiri antreannya. Lebih baik agent berhenti dan bertanya soal tujuan dulu, seperti prinsip Goal Forge: AI Jangan Langsung Jalan.
Yang tidak dikatakan paper ini
Biar adil:
- Paper ini tidak bilang AI agent nggak berguna. Kode memang naik signifikan.
- Paper ini tidak menemukan penurunan lapangan kerja engineer yang signifikan (estimasinya noisy).
- Ini data perusahaan yang memakai Jellyfish, jadi belum tentu mewakili tim kecil atau solo developer.
Interpretasi saya: agent bekerja. Organisasinya yang belum menyesuaikan diri.
Penutup
Era "AI menulis kode" sudah lewat. Sekarang eranya "siapa yang bisa memverifikasi dengan cepat".
Tim yang menang bukan yang punya agent paling banyak. Tim yang menang adalah yang merancang ulang alur review, test, dan deploy supaya bisa menelan output agent tanpa tersedak.
Kalau agent kamu lebih cepat dari reviewer kamu, yang perlu di-upgrade bukan agent-nya.
FAQ
Apa temuan utama riset Harvard soal AI coding agent?
Adopsi AI agent menaikkan output kode antara (lines of code, commits, PR), tapi output software akhir naik jauh lebih kecil, sementara waktu review melonjak.
Kenapa angka di berita berbeda dengan paper?
Paper diperbarui. Angka yang viral (PR +23%, review +49%) berasal dari versi sebelumnya; versi 31 Oktober 2026 memuat estimasi baru, misalnya waktu merge +56,1%.
Apakah AI code reviewer bisa menyelesaikan bottleneck?
Menurut liputan InfoQ, penulis tidak menemukan perbaikan dari adopsi AI untuk membantu review. AI reviewer tetap berguna sebagai filter, tapi bukan solusi tunggal.
Metrik apa yang sebaiknya dipakai?
Lead time ke production, issue yang selesai, waktu tunggu review, dan rework, bukan jumlah baris kode atau jumlah PR.
Apakah ini berlaku untuk automation non-coding?
Polanya sama: kalau produksi naik tanpa kapasitas verifikasi, hasilnya antrean dan noise, bukan produktivitas.
← Artikel Sebelumnya
Meta Muse Masuk Singapura: Personal AI Agent Mulai Pegang Dompet Kita
Artikel Selanjutnya →
Cartesia Managed Agents: Voice AI Akhirnya Belajar Mendengar
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.