
Suruh AI Teliti Analisis, Berani Rekomendasi: Satu Kalimat, Banyak Efek
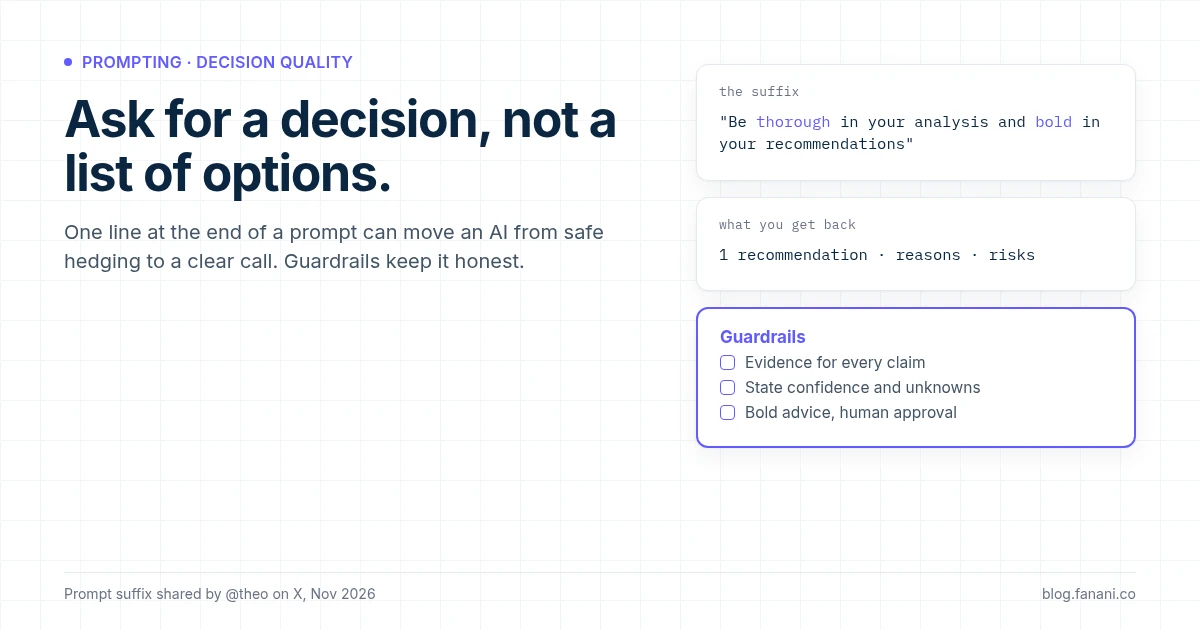
Pernah minta AI bantu ambil keputusan, terus jawabannya lima opsi rapi, masing-masing ada plus-minusnya, dan ditutup "semua tergantung kebutuhan kamu"?
Secara teknis jawabannya benar. Secara praktis, nggak ada gunanya.
Saya sering ngalamin ini waktu minta pendapat soal arsitektur bot, pilihan VPS, atau urutan prioritas kerjaan. Analisisnya panjang, tapi keputusannya tetap dibalikin ke saya. Padahal alasan saya nanya ya karena butuh second opinion yang berani.
Awal November 2026, Theo membagikan satu kalimat penutup prompt yang lagi sering dia pakai:
"Be thorough in your analysis and bold in your recommendations"
Kalimatnya pendek. Tapi menurut saya ini salah satu suffix paling berguna buat kerja harian dengan AI agent, asal kamu paham kenapa dia bekerja dan di mana bahayanya.
Kenapa AI suka main aman
Ada dua hal yang bikin jawaban AI cenderung ngambang.
Pertama, model mengikuti apa yang kamu minta, bukan apa yang kamu maksud. Panduan prompting resmi Anthropic menulis jelas: kalau kamu mau Claude melakukan lebih dari yang diminta secara ketat, minta secara eksplisit, jangan berharap model menebak dari prompt yang samar (Claude prompting best practices). Contoh mereka bahkan spesifik: "Can you suggest some changes" sering menghasilkan saran saja, bukan perubahan.
Jadi kalau kamu nanya "menurutmu gimana?", model menjawab persis itu: pendapat yang hati-hati.
Kedua, model dilatih untuk disukai. Riset Anthropic soal sycophancy (Sharma dkk., 2023) menemukan lima AI assistant konsisten menunjukkan perilaku menjilat di empat jenis tugas: gampang mengaku salah waktu ditekan user, kasih feedback yang bias, dan ikut-ikutan kesalahan user. Salah satu penyebab yang mereka duga: data preferensi manusia lebih sering memilih jawaban yang sejalan dengan pandangan si penanya.
Gabungkan dua hal itu, dan hasilnya jawaban yang sopan, lengkap, dan nggak berani ambil posisi.
Lesson: AI yang ngambang bukan bodoh. Dia cuma belum diberi izin untuk tegas.
Apa yang sebenarnya dilakukan suffix ini
Kalimat Theo punya dua instruksi yang sengaja dipasangkan.
- "Thorough in your analysis" — jangan lompat ke kesimpulan. Bongkar dulu masalahnya, cek asumsi, lihat sisi yang nggak kelihatan.
- "Bold in your recommendations" — setelah analisis, ambil posisi. Pilih satu. Bilang apa yang harus dilakukan.
Pasangan ini penting. Kalau cuma "be bold", kamu dapat opini keras yang dangkal. Kalau cuma "be thorough", kamu dapat esai panjang yang tetap nggak memutuskan apa-apa.
Ini sejalan dengan saran Anthropic juga: tambahkan modifier yang mendorong kualitas dan detail. Contoh mereka, dari "Create an analytics dashboard" jadi "...Include as many relevant features and interactions as possible. Go beyond the basics." Suffix Theo adalah versi yang sama, tapi untuk keputusan, bukan untuk kode.
Di pengalaman saya, efek paling kelihatan ada di tiga jenis pertanyaan:
- Prioritas — "dari 8 ide ini, mana yang dikerjakan minggu ini?" Jawabannya jadi urutan, bukan daftar.
- Review — "cek rencana migrasi ini." Model lebih berani bilang "langkah 3 ini salah, ganti."
- Pilihan tool atau arsitektur — keluar satu rekomendasi plus alasan kenapa yang lain kalah.
Bahayanya: berani itu bukan berarti benar
Ini bagian yang sering dilewatkan orang yang copas prompt dari timeline.
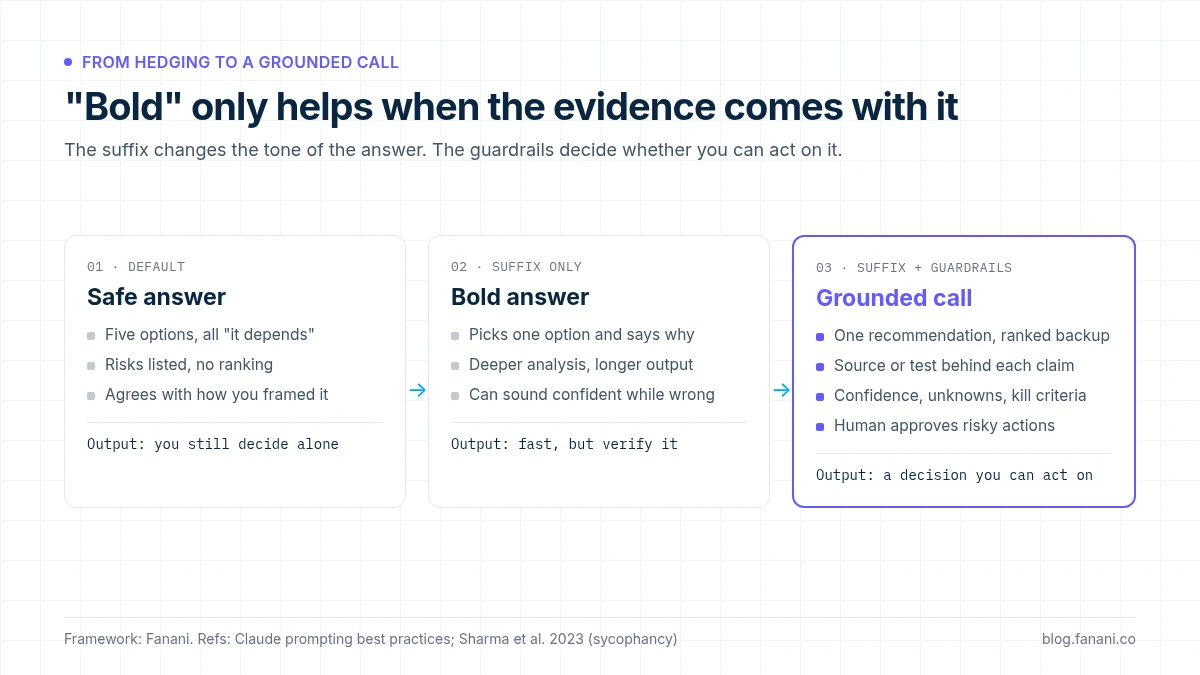
Kata "bold" mengubah nada jawaban. Dia nggak otomatis menambah bukti. Model yang disuruh berani bisa tetap salah, cuma sekarang salahnya terdengar yakin. Riset sycophancy tadi juga mencatat bahwa manusia dan preference model kadang lebih memilih jawaban menjilat yang ditulis meyakinkan dibanding jawaban yang benar. Artinya, kalimat yang meyakinkan itu sendiri sudah jadi jebakan.
Untuk pertanyaan santai, risikonya kecil. Untuk AI agent yang punya akses tool, ceritanya beda. Rekomendasi "berani" yang langsung dieksekusi bisa jadi rm yang salah folder, migrasi database tanpa backup, atau email ke customer yang nggak perlu.
Saran saya tegas: pakai suffix ini untuk rekomendasi, jangan untuk eksekusi. Biarkan model berani di tahap mikir. Di tahap bertindak, tetap ada gate.
Versi yang saya pakai: berani, tapi ada pagarnya
Saya nggak pakai kalimat Theo mentah-mentah untuk keputusan penting. Saya tambah tiga baris supaya keberaniannya bisa dicek.
Be thorough in your analysis and bold in your recommendations.

Rules:
- Give ONE primary recommendation, then a ranked backup.
- Back every key claim with a source, a test, or say "assumption".
- State your confidence (high/medium/low) and what would change your mind.
- Do not execute risky or irreversible actions. Propose them for my approval.
Setiap baris punya fungsi:
- One recommendation + backup — memaksa keputusan, tapi tetap ada rencana B kalau pilihan utama gagal.
- Source, test, atau "assumption" — ini pagar paling penting. Kalau agent punya akses search, suruh dia cek sumber resmi dulu, seperti yang saya bahas di Search MCP untuk AI agent.
- Confidence + kill criteria — "apa yang bikin kamu ganti pendapat" jauh lebih berguna dari skor keyakinan. Itu jadi checklist saya untuk verifikasi.
- Approval untuk aksi berisiko — keberanian di analisis, kehati-hatian di eksekusi. Prinsip yang sama dengan approval manusia sesuai risiko di code review era AI agent.
Contoh nyata: sebelum dan sesudah
Misalnya saya tanya ke agent: "Bot monitoring saya sering kirim alert palsu. Gimana sebaiknya?"
Tanpa suffix, jawaban khasnya kira-kira begini: bisa naikkan threshold, bisa tambah debounce, bisa ganti tool monitoring, bisa pakai anomaly detection, semua ada trade-off-nya.
Dengan suffix + rules, polanya berubah:
- Rekomendasi utama: tambah debounce dan syarat "gagal X kali berturut-turut" sebelum kirim alert.
- Backup: kalau masih ramai, pisahkan alert jadi level warning dan critical.
- Alasan: penyebab yang paling mungkin dari log adalah flapping, bukan threshold yang salah. Ditandai "assumption" karena belum dicek ke log lengkap.
- Kill criteria: kalau log menunjukkan alert palsu datang dari satu endpoint saja, berarti masalahnya di endpoint itu, bukan di sistem alert.
- Aksi yang perlu approval: mengubah config monitoring di server produksi.
Versi kedua bisa langsung saya kerjakan. Dan bagian "assumption" kasih tahu saya persis apa yang harus dicek dulu.
Lesson: jawaban yang bagus bukan yang paling yakin, tapi yang paling jelas bisa dibuktikan salah.
Di mana sebaiknya ditaruh
Untuk pemakaian harian, saya taruh suffix ini di tiga tempat:
- Di akhir prompt ad-hoc — untuk pertanyaan keputusan. Cepat dan nggak perlu setting apa-apa.
- Di system prompt agent "advisor" — kalau kamu punya agent yang tugasnya review atau kasih second opinion. Kalau timnya dipecah per spesialis, taruh di agent yang perannya memang menilai.
- Di template brief sebelum eksekusi — gabungkan dengan scope dan stopping condition seperti di Goal Forge, supaya rekomendasi berani tetap berada di dalam batas yang jelas.
Yang jangan: menaruhnya di agent eksekutor yang jalan otomatis tanpa gate. Panduan Anthropic juga mengingatkan bahwa model yang lebih baru sudah lebih proaktif, dan instruksi yang dulu dipakai untuk mendorong model bisa jadi overtrigger. Kalau agent kamu sudah agresif, menambah "bold" bisa bikin dia makin nekat.
Kalau suatu saat rekomendasi berani itu terbukti salah, jangan cuma koreksi di chat. Catat polanya dan jadikan pagar permanen, seperti konsep failure ledger.
Penutup
Suffix "thorough in your analysis, bold in your recommendations" bekerja karena dia memberi izin yang selama ini nggak kita kasih: izin untuk mengambil posisi.
Tapi izin itu harus datang bersama kewajiban. Bukti untuk tiap klaim, tingkat keyakinan yang jujur, dan gate manusia sebelum aksi yang nggak bisa dibatalkan.
AI yang berani tanpa bukti itu bahaya. AI yang teliti tanpa keberanian itu buang waktu. Kamu butuh dua-duanya.
FAQ
Apakah suffix ini cuma berlaku untuk Claude?
Nggak. Kalimatnya bahasa biasa, jadi bisa dipakai di model mana pun. Referensi di artikel ini memang dari panduan Anthropic, tapi prinsip "minta secara eksplisit apa yang kamu mau" berlaku umum. Tetap tes di model yang kamu pakai.
Bukannya jawaban jadi lebih panjang dan boros token?
Bagian "thorough" memang cenderung menambah panjang. Kalau perlu ringkas, tambah instruksi format, misalnya "rekomendasi di paragraf pertama, analisis di bawah".
Apa bedanya dengan menyuruh AI "jangan setuju-setuju saja"?
"Jangan menjilat" itu melarang. Suffix ini memberi arah: analisis dalam, lalu putuskan. Menurut saya instruksi positif lebih mudah diikuti daripada larangan, dan bisa digabung kalau kamu memang sering dapat jawaban yang sekadar membenarkan.
Kapan sebaiknya nggak dipakai?
Saat kamu justru butuh eksplorasi luas, misalnya brainstorming awal, atau saat agent punya akses eksekusi tanpa approval. Di situ keberanian lebih banyak risikonya daripada manfaatnya.
Bagaimana tahu rekomendasinya bisa dipercaya?
Lihat bagian bukti dan kill criteria. Kalau klaim pentingnya nggak punya sumber atau test, perlakukan sebagai hipotesis, bukan keputusan.
← Artikel Sebelumnya
Auto-Compact 400K di Claude Code: Hemat Usage, Tapi Pahami Harganya
Artikel Selanjutnya →
"Bikin Modern" Bukan Brief: Prompt UI/UX yang Bisa Dicek AI Agent
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.