
Search MCP untuk AI Agent: Biar Nggak Ngarang, Suruh Cek Sumber Resmi
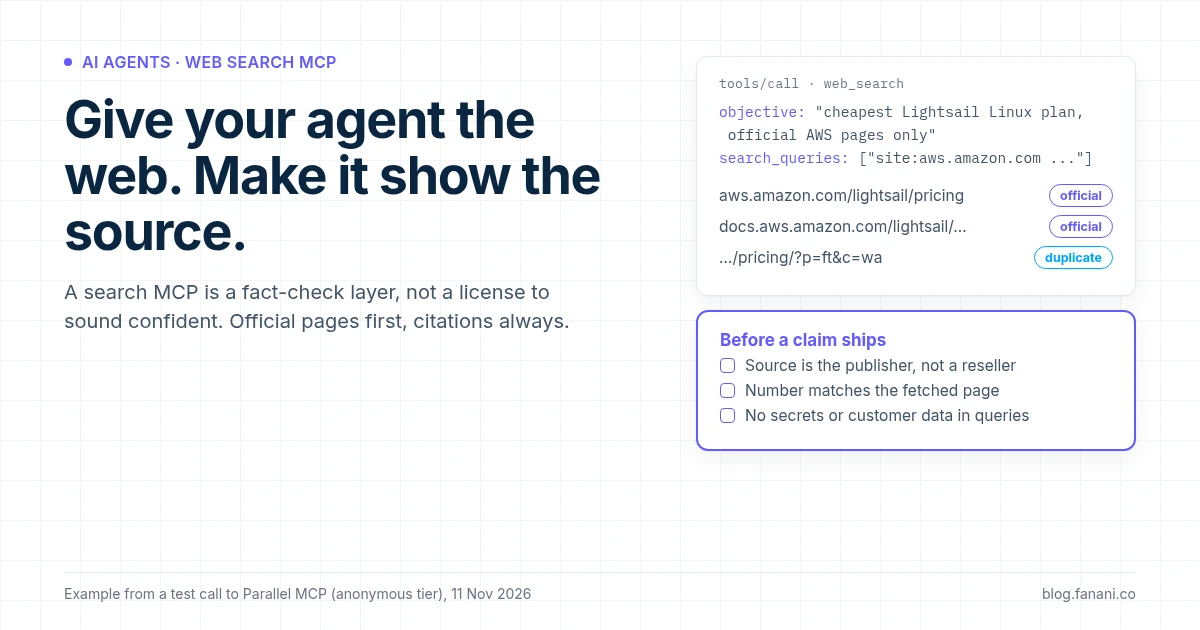
Penyakit AI agent yang paling mahal itu bukan error.
Error kelihatan. Yang mahal itu jawaban yang terdengar yakin tapi salah: harga paket yang sudah berubah, limit API versi tahun lalu, fitur yang ternyata cuma ada di roadmap. Agent nulis dengan nada pasti, kamu copy ke proposal, dan baru ketahuan pas klien nanya balik.
Makanya saya makin yakin: kalau agent kamu nulis sesuatu yang bakal dibaca orang lain, dia butuh fact-check layer. Bukan sekadar "bisa browsing", tapi kebiasaan cek sumber resmi sebelum klaim keluar.
Belakangan saya lagi nyoba salah satu opsi yang cukup menarik buat ini: Parallel MCP. Di artikel ini saya bahas apa yang saya temukan waktu ngetes langsung, plus rutinitas verifikasi yang saya pasang ke agent.
Kenapa topik ini muncul lagi
Ada post dari @okapi_fukugyo yang cerita dia pasang Parallel ke agent-nya, dan proses "cek ke sumber resmi" jadi jauh lebih cepat. Klaimnya: satu kali search, sekitar 1 detik, untuk cek satu halaman resmi. Sebelumnya dia harus search lalu buka 2–3 halaman resmi bolak-balik.
Contoh use case yang dia tulis juga praktis banget: cek harga dan free tier tool cuma dari sumber resmi, baca sampai 20 halaman sekaligus untuk dibikin tabel perbandingan, ambil isi PDF dari URL, sampai baca changelog terbaru waktu ngoding.
Parallel sendiri bukan startup random. Perusahaannya, Parallel Web Systems, didirikan oleh mantan CEO Twitter Parag Agrawal, dan Reuters melaporkan mereka raise $100 juta pada November 2025.
Tapi nama founder nggak bikin tool otomatis benar. Jadi saya tes sendiri.
Apa yang kamu dapat tanpa API key
Menurut halaman resmi Parallel MCP dan dokumentasinya, server-nya ada di satu URL: https://mcp.parallel.ai/mcp. Tanpa akun dan tanpa API key, kamu dapat web_search, web_fetch, dan web_decisions dengan rate limit lebih rendah. web_research (riset mendalam) butuh login atau API key.
Waktu saya panggil tools/list secara anonim, server-nya malah mengembalikan 7 tool: web_search, web_fetch, web_decisions, find_verticals, search_vertical, image_search, dan send_feedback.
Pasangnya juga satu baris, sesuai docs:
# Claude Code
claude mcp add --transport http parallel https://mcp.parallel.ai/mcp

# Codex
codex mcp add parallel --url https://mcp.parallel.ai/mcp
Satu jebakan kecil yang ditulis di FAQ mereka: jangan pakai trailing slash. https://mcp.parallel.ai/mcp/ balikin 404.
Kalau lewat batas gratis, request-nya di-rate limit, bukan ditagih. Kalau nanti pakai API key, harga search mode fast dan turbo tercatat $1 per 1.000 request, basic dan advanced $5 per 1.000 request (pricing docs). Untuk dipakai satu orang atau satu tim kecil, anonymous tier sudah cukup buat mulai.
Saya tes: 10 hasil bukan berarti 10 sumber
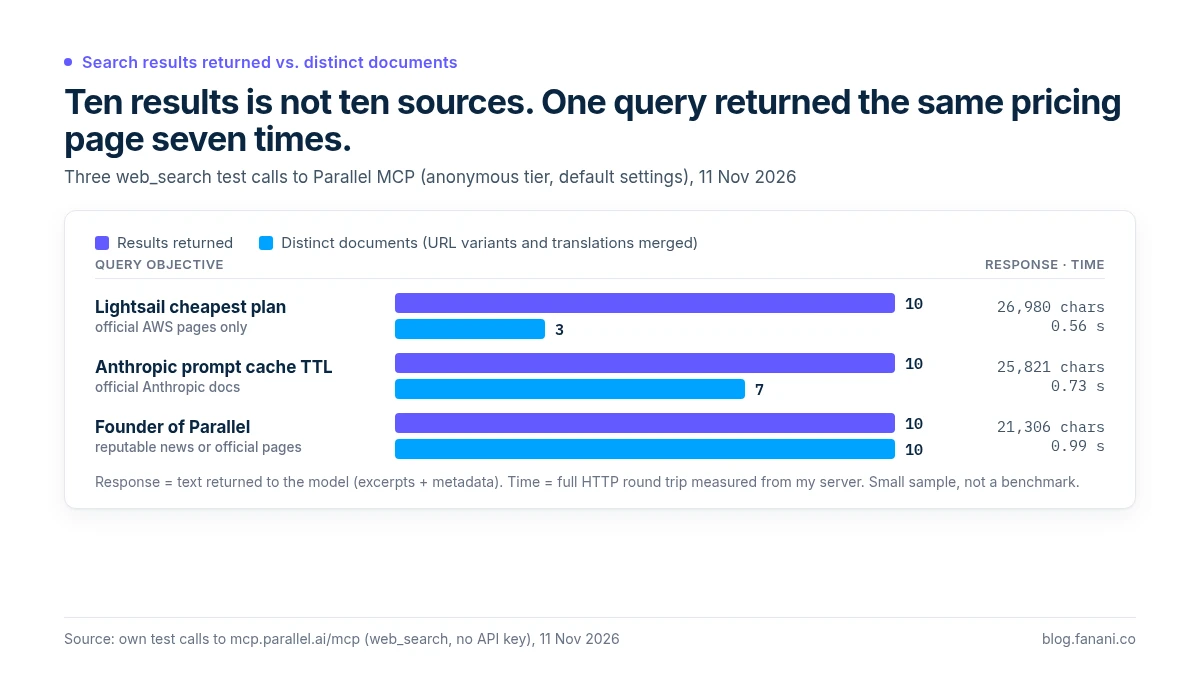
Saya kirim tiga query web_search langsung ke endpoint MCP-nya, tanpa API key, setting default. Objective-nya sengaja klaim yang bisa saya cek sendiri:
- Harga paket Linux termurah Amazon Lightsail, khusus halaman resmi AWS.
- TTL default prompt caching Anthropic, khusus docs resmi.
- Siapa founder Parallel, dari media kredibel atau halaman resmi.
Hasilnya:
- Semua request selesai di bawah 1 detik dari server saya (0,56 s; 0,73 s; 0,99 s, full HTTP round trip).
- Ketiganya mengembalikan 10 hasil, dan hasil teratas memang dari publisher resmi:
aws.amazon.com/lightsail/pricing,docs.anthropic.com/.../prompt-caching, dan artikel Reuters. - Excerpt Lightsail sudah memuat angka $3.50/bulan untuk bundle IPv6-only. Excerpt Anthropic sudah memuat info cache 5 menit.
Tapi ada satu hal yang bikin saya berhenti sebentar.
Query Lightsail mengembalikan 10 hasil, tapi cuma 3 dokumen unik. Halaman pricing yang sama muncul 7 kali: versi dengan query string berbeda, plus versi bahasa Indonesia dan Mandarin. Query Anthropic: 10 hasil, 7 dokumen unik. Cuma query founder yang benar-benar 10 sumber berbeda.
Kenapa ini penting? Karena agent gampang salah baca "10 hasil setuju" sebagai "10 sumber setuju". Padahal itu satu halaman yang muncul berkali-kali. Konfirmasi palsu.
Dan tiap response sekitar 21–27 ribu karakter teks yang masuk ke context model. Kalau agent kamu panggil search 10 kali dalam satu task, itu bukan gratis meskipun tool-nya gratis. Saya sudah bahas pola ini di kuota AI agent cepat habis: yang boros sering bukan modelnya, tapi berapa banyak bahan yang kamu suapkan.
Lesson: Hitung dokumen, bukan hasil. Satu halaman yang muncul tujuh kali tetap satu sumber.
Rutinitas verifikasi yang saya pasang ke agent
Tool search cuma setengah cerita. Setengahnya lagi adalah aturan kapan dan gimana agent wajib cek. Ini rutinitas lima langkah yang saya pakai:
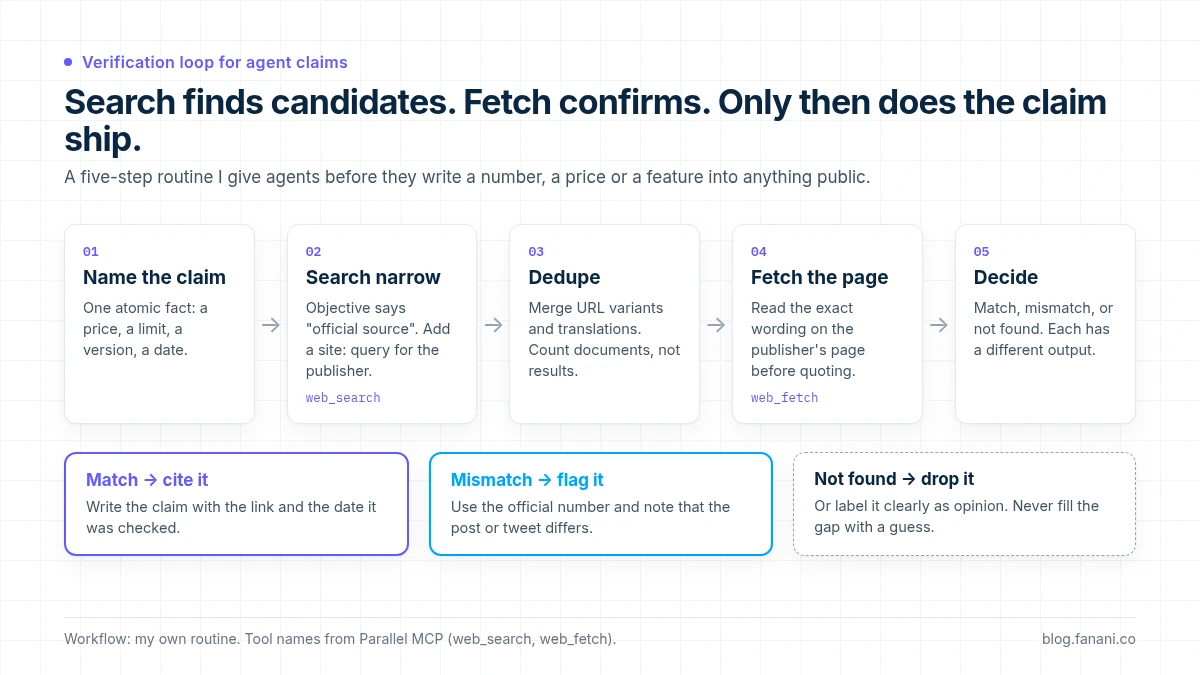
- Name the claim. Pecah jadi satu fakta atomik: satu harga, satu limit, satu versi, satu tanggal. Jangan "cek semua soal Lightsail".
- Search narrow. Di
objective, tulis eksplisit "official source only". Tambah satu querysite:ke domain publisher. - Dedupe. Gabungkan URL yang cuma beda query string atau bahasa. Kalau setelah dedupe tinggal satu dokumen, ya itu satu sumber.
- Fetch halaman aslinya. Kalau angkanya mau dikutip, panggil
web_fetchke URL resmi itu. Excerpt itu potongan, bukan konteks lengkap. - Decide. Tiga kemungkinan, tiga output berbeda:
- Match → tulis klaimnya, sertakan link dan tanggal dicek.
- Mismatch → pakai angka resmi, catat bahwa post/tweet sumbernya beda.
- Not found → buang klaimnya, atau tulis jelas sebagai opini.
Langkah 5 yang paling sering dilewati. Agent cenderung "mengisi kekosongan" kalau nggak dikasih izin eksplisit untuk bilang "nggak ketemu".
Contoh instruksi yang saya tempel ke system prompt atau skill agent:
Before writing any price, limit, version, date or feature claim:
1. Run web_search with an objective that says "official source only"
   and one site: query for the publisher's domain.
2. Merge duplicate URLs (query strings, language versions).
3. If you will quote a number, web_fetch the official page first.
4. Output one of: MATCH (cite link + date checked),
   MISMATCH (official value + note), NOT FOUND (drop or mark as opinion).
Never fill a missing fact with an estimate.
Soal domain: Parallel punya include_domains di source policy, tapi docs mereka sendiri kasih warning bahwa membatasi domain bisa menurunkan kualitas hasil, dan menyarankan steering lewat objective saja kalau tujuannya cuma "lebih suka sumber resmi". Dari tes saya, steering di objective plus satu query site: sudah cukup membuat publisher resmi muncul paling atas.
Pagar yang tetap wajib
Search MCP itu tool yang membawa konten dari luar masuk ke context agent. Artinya semua aturan soal connector tetap berlaku.
Query kamu keluar dari mesinmu. Apa pun yang agent tulis di objective dan search_queries dikirim ke server pihak ketiga. Jangan biarkan agent menaruh nama klien, isi email, token, atau data internal di query. Tulis aturannya eksplisit.
Hasil search itu untrusted input. Halaman web bisa berisi instruksi tersembunyi. Ini kelas masalah yang sama dengan MCP tool poisoning: konten tool boleh dibaca dan diringkas, tapi tidak boleh memerintah agent.
Perhatikan tool yang bisa mengirim keluar. Di daftar tool anonim tadi ada send_feedback, yang mengirim laporan ke tim Parallel. Deskripsi tool-nya sendiri sudah benar: agent harus tanya user dulu dan menunjukkan isi yang akan dikirim. Tapi saya tetap lebih suka membatasi tool dari sisi config. Docs mereka mendukung parameter tools di URL, misalnya https://mcp.parallel.ai/mcp?tools=web_search,web_fetch, jadi agent cuma melihat tool yang memang kamu butuhkan. Pola yang mirip pernah saya bahas di Vercel MCP submit_feedback.
Jangan tambah connector tanpa audit. Kalau agent kamu sudah punya tiga tool search dari plugin berbeda, nambah satu lagi bikin agent bingung pilih yang mana, dan deskripsi tool ikut makan context. Cek dulu pakai Plugin Diet.
Kapan pakai search MCP, kapan cara lain
Ini pembagian kerja yang saya pakai sekarang:
- Cek satu fakta publik (harga, limit, tanggal rilis) →
web_search+web_fetchke halaman resmi. - Baca post X tertentu → JSON API, seperti di AI agent baca X tanpa browser.
- Data di balik login (dashboard, admin panel) → API resmi atau connector; browser cuma kalau terpaksa, lihat Cloud Browser untuk AI agent.
- Riset panjang dengan banyak sumber → mode riset berbayar atau kerjakan bertahap, jangan 30 search beruntun.
Search MCP bukan pengganti semua itu. Dia pas di satu slot: fakta publik yang berubah-ubah dan harus bisa dicek orang lain.
Penutup
Agent yang bisa search itu biasa. Agent yang tahu kapan wajib search, bisa membedakan satu sumber dari sepuluh hasil, dan berani bilang "nggak ketemu" itu yang bisa dipercaya.
Tool gratis seperti Parallel MCP bikin langkah verifikasi jadi murah dan cepat. Tapi disiplinnya tetap harus kamu yang tulis.
FAQ
Apakah Parallel MCP benar-benar gratis?
Untuk web_search, web_fetch, dan web_decisions, bisa dipakai tanpa akun dan tanpa API key dengan rate limit lebih rendah. Kalau lewat batas, request di-rate limit, bukan ditagih. web_research butuh login atau API key.
Agent saya sudah punya web search bawaan. Masih perlu?
Belum tentu. Yang lebih penting adalah rutinitas verifikasinya: objective yang eksplisit minta sumber resmi, dedupe, fetch halaman asli, dan output MATCH/MISMATCH/NOT FOUND. Rutinitas itu bisa jalan di tool search mana pun.
Kenapa harus dedupe hasil search?
Karena satu halaman bisa muncul berkali-kali dengan URL berbeda. Di tes saya, satu query mengembalikan 10 hasil tapi cuma 3 dokumen unik. Tanpa dedupe, agent bisa menganggap satu sumber sebagai konfirmasi berlapis.
Amankah memasang search MCP pihak ketiga?
Aman kalau ada pagarnya: jangan kirim data internal atau data klien di query, perlakukan hasil search sebagai untrusted input, dan batasi tool yang terlihat agent ke yang benar-benar dibutuhkan.
Mode search mana yang dipakai?
Docs Parallel menyarankan fast untuk sebagian besar agent. turbo paling rendah latency-nya, tapi saat ini hanya mendukung query bahasa Inggris dan Jepang, jadi untuk query bahasa Indonesia docs-nya menyarankan basic atau advanced.
← Artikel Sebelumnya
Cloud Browser untuk AI Agent: Semua Jadi Bisa, Tapi Bukan Gratis
Artikel Selanjutnya →
Email Domain untuk AI Agent: Terima Gratis Itu Gampang, Kirimnya yang Susah
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.