
AI Agent Baca X Tanpa Browser: Satu Request JSON, Bukan Klik
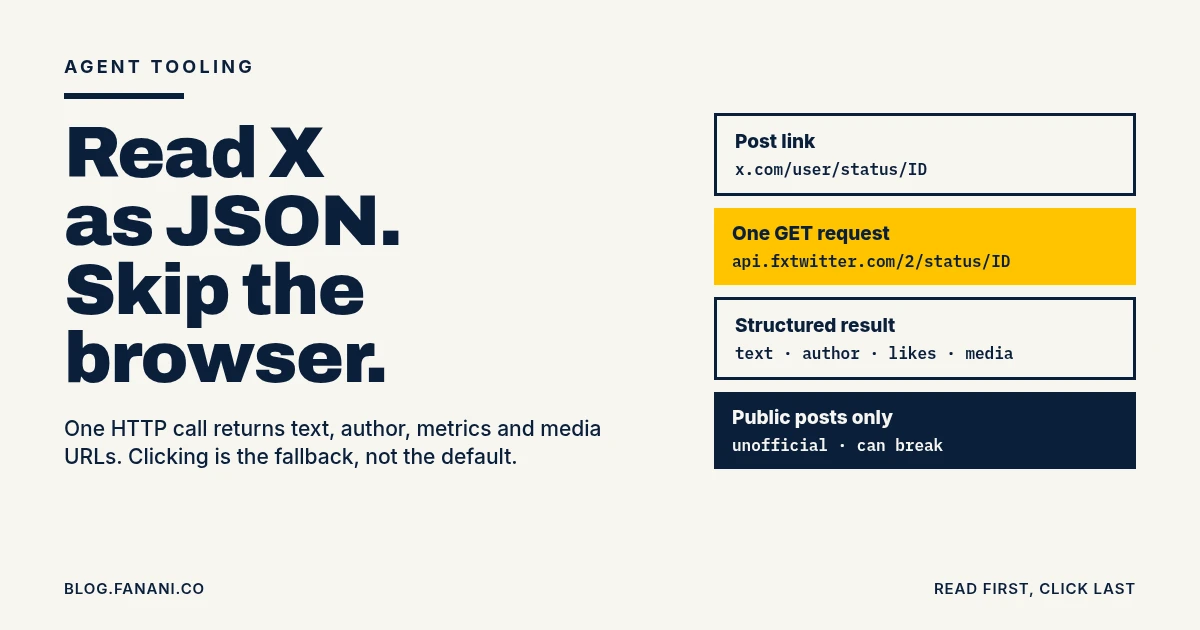
Ada satu kebiasaan AI agent yang bikin saya gemas: dikasih link post X, dia langsung buka browser.
Load halaman, tunggu JavaScript, scroll, kadang ketemu login wall, lalu screenshot buat "membaca" teksnya. Lama, boros token, dan hasilnya sering setengah jadi. Padahal yang dibutuhkan cuma tiga hal: isi post, siapa yang nulis, dan media yang nempel.
Untuk post publik, ada jalan yang jauh lebih pendek: minta agent baca lewat FxTwitter API, satu request HTTP, hasilnya JSON.
Ide ini lagi ramai dibahas pengguna agent. Salah satunya post @chikaidev yang menyuruh agent-nya: "mulai sekarang kalau baca X, pakai fxtwitter, lewat CLI, jangan buka browser." Di screenshot-nya, agent langsung tes dengan curl ke api.fxtwitter.com dan melaporkan dapat teks, author, likes, views, plus URL mp4 video secara langsung. Lalu agent itu menyimpan aturan tersebut ke memorinya.
Saya setuju dengan arahnya. Tapi ada beberapa pagar yang wajib dipasang dulu.
Kenapa browser itu pilihan terakhir buat membaca
Browser automation itu alat yang hebat. Saya sendiri pernah nulis tutorial browser control dengan OpenClaw dan bahas agent-desktop yang baca accessibility tree.
Tapi browser itu buat bertindak: klik, isi form, navigasi di app yang nggak punya API. Buat membaca data yang sudah tersedia terstruktur, browser itu jalan memutar.
Masalahnya konkret:
- Lambat. Agent harus nunggu halaman render, bukan cuma nunggu data.
- Rapuh. Layout berubah, popup login muncul, selector meleset.
- Boros konteks. Kalau agent membaca lewat screenshot atau DOM, banyak token habis untuk navigasi, tombol, dan rekomendasi yang nggak relevan.
- Susah diverifikasi. Angka likes hasil "lihat" screenshot lebih gampang salah baca daripada angka di field JSON.
Lesson: kalau datanya bisa diambil sebagai JSON, jangan suruh agent mengambilnya dengan mata.
FxTwitter itu apa
FxTwitter adalah bagian dari proyek open-source FxEmbed. Awalnya dibuat untuk memperbaiki embed link X/Twitter di Discord, Telegram, dan app chat lain. Repo-nya berlisensi MIT, dan per 9 November 2026 punya 5.874 star di GitHub.
Yang menarik buat agent: mereka membuka API publik. Dari dokumentasinya:
- Base URL
https://api.fxtwitter.com, endpoint terbaru ada di prefix/2/. - Endpoint yang tersedia mencakup post, thread, conversation, profil, search, dan trends.
- Response selalu JSON, dengan field
codeyang mencerminkan status HTTP. - Rate limit API v2 tertulis 1.000 request per menit per IP.
- Ada spesifikasi OpenAPI di
https://api.fxtwitter.com/2/openapi.json, jadi agent bisa membaca sendiri endpoint apa saja yang ada.
Satu hal penting dari README-nya: proyek ini tidak berafiliasi dengan X Corp. Ini layanan pihak ketiga. Ingat itu, nanti kita balik ke sini.
Coba sendiri: satu post, satu request
Formatnya simpel. Ambil ID dari link post, lalu:
curl -s https://api.fxtwitter.com/2/status/2119662673168400476
Saya tes endpoint itu hari ini. Response-nya berisi field seperti text, author, replies, reposts, likes, bookmarks, views, created_at, lang, community_note, dan media. Untuk post bergambar, media.photos langsung memberi URL gambar beserta lebar dan tingginya.
Untuk thread, pakai endpoint thread:
curl -s https://api.fxtwitter.com/2/thread/POST_ID
Saya coba di satu thread lima post, dan hasilnya keluar sebagai array thread berisi lima item. Agent nggak perlu scroll dan klik "show more replies".
Kalau mau ambil field tertentu saja, gabungkan dengan jq:
curl -s https://api.fxtwitter.com/2/status/POST_ID \
  | jq '{text: .status.text, by: .status.author.screen_name, likes: .status.likes, media: [.status.media.all[]?.url]}'
Output yang kecil dan rapi seperti ini yang seharusnya masuk ke konteks agent. Bukan halaman web utuh.
Berapa beda datanya
Saya ukur sendiri, biar bukan cuma klaim. Lima post publik, diambil pakai curl dari satu server pada 9 November 2026. Yang dibandingkan: ukuran response JSON dari FxTwitter API versus HTML mentah halaman post di x.com.
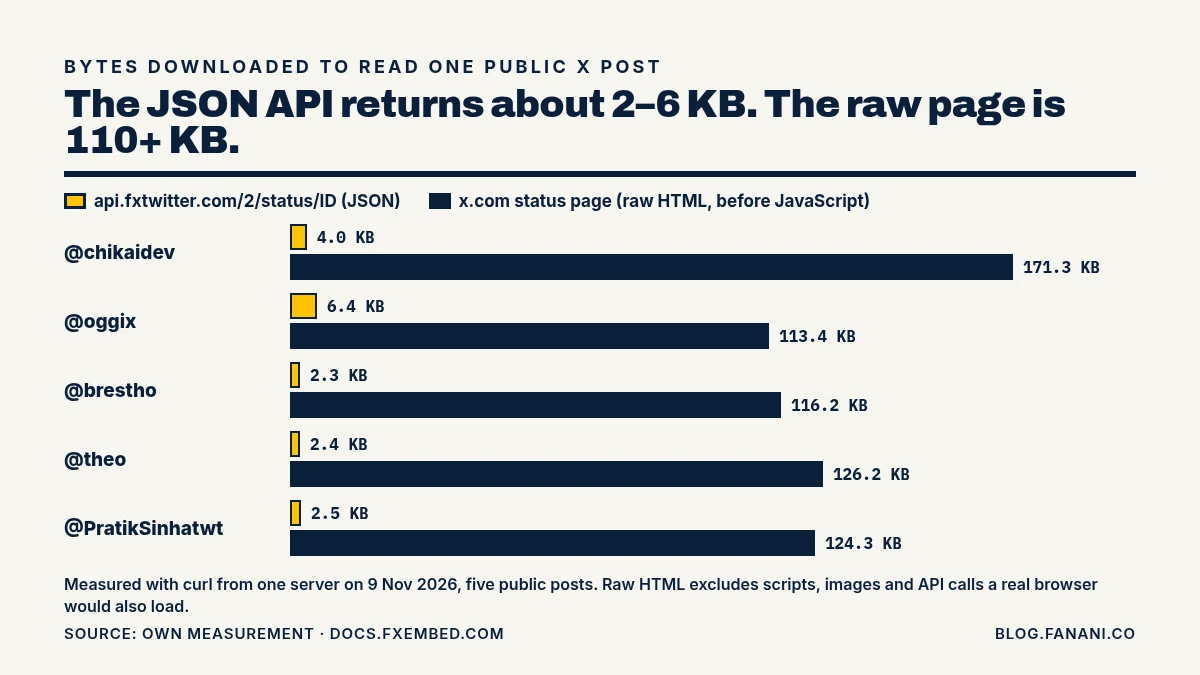
Hasilnya, JSON-nya sekitar 2,3 sampai 6,4 KB per post. HTML mentahnya 113 sampai 171 KB.
Dua catatan supaya angkanya jujur:
- HTML mentah itu belum termasuk JavaScript, gambar, dan request tambahan yang dimuat browser sungguhan. Jadi beban browser aslinya lebih besar lagi, tapi saya tidak mengukurnya, jadi nggak saya kasih angka.
- Ini ukuran byte, bukan token. Tapi arahnya jelas: makin kecil dan terstruktur input-nya, makin sedikit yang harus dicerna model.
Kecepatan juga beda, tapi itu sangat tergantung jaringan, jadi saya nggak mau bikin klaim angka umum dari satu server.
Jadikan aturan permanen, bukan pesan sekali lewat
Bagian paling bagus dari contoh @chikaidev bukan curl-nya. Tapi momen agent bilang aturan itu sudah dimasukkan ke memori.
Itu pola yang sama dengan yang saya bahas di AI agent jangan salah dua kali: setiap kali agent melakukan sesuatu dengan cara boros, ubah koreksinya jadi aturan tertulis, bukan nasihat yang hilang di sesi berikutnya.
Contoh aturan yang bisa kamu taruh di memory, system prompt, atau file AGENTS.md:
## Membaca post X
- Untuk link post X publik: ambil status ID, panggil
  https://api.fxtwitter.com/2/status/<ID> (thread: /2/thread/<ID>).
- Cek field `code` = 200 sebelum memakai data.
- Ambil hanya field yang dibutuhkan (text, author, metrics, media URL).
- Jangan buka browser kecuali API gagal atau tugasnya memang butuh interaksi.
- Jangan pernah kirim cookie, token, atau link privat ke layanan ini.
- Kalau angka metrik dipakai di laporan, sebutkan tanggal pengambilannya.
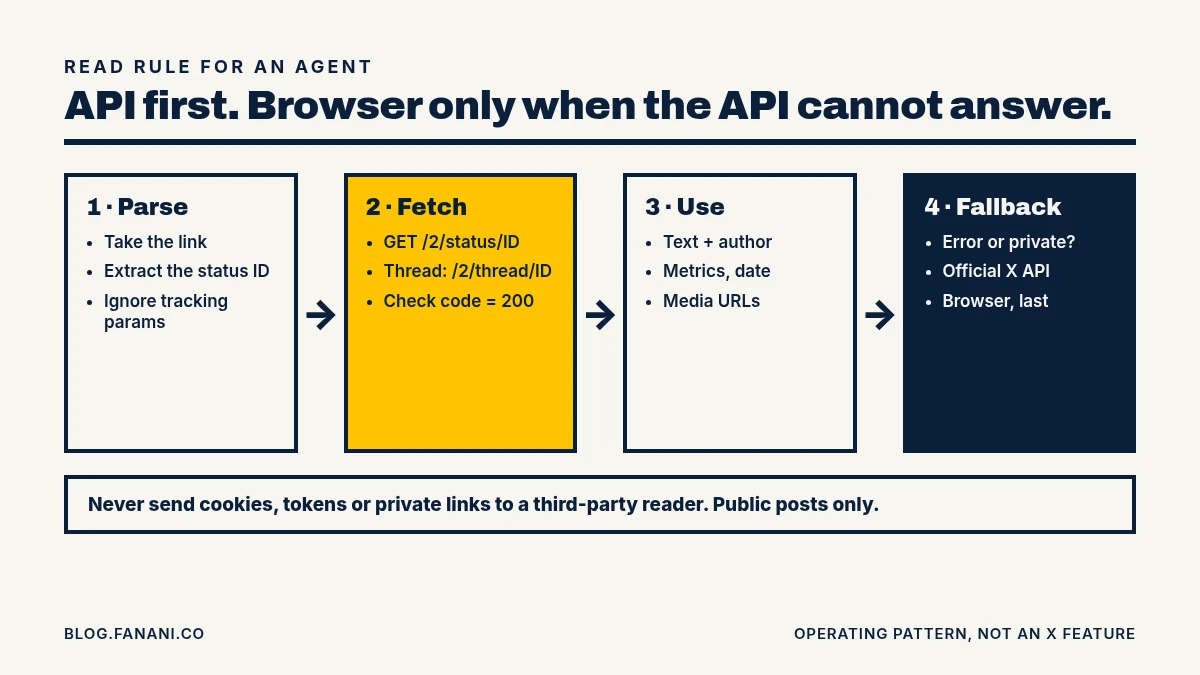
Urutannya sederhana: parse, fetch, pakai, dan baru fallback kalau gagal.
Pagar yang wajib dipasang
Sekarang bagian yang sering di-skip orang.
1. Ini bukan API resmi X
FxTwitter dikelola komunitas, tidak berafiliasi dengan X Corp. Artinya bisa berubah, bisa down, bisa kena pembatasan kapan saja. Jangan bikin workflow bisnis kritis yang satu-satunya jalur datanya lewat sini.
Kalau kamu butuh data X untuk produk, volume besar, atau hal yang menyangkut kontrak, pakai X API resmi. Status FxTwitter bisa dicek di status page mereka.
2. Publik saja
Yang bisa dibaca lewat layanan seperti ini ya data publik. Bookmark, DM, timeline pribadi, post dari akun yang dikunci: itu wilayah akun kamu sendiri dan harus lewat jalur resmi yang login sebagai kamu.
Dan aturan paling keras: jangan pernah kasih cookie sesi, auth token, atau kredensial X ke layanan pihak ketiga mana pun demi "biar bisa baca lebih banyak". Itu bukan optimasi. Itu menyerahkan akun.
3. Data pihak ketiga tetap harus dicek
Angka likes dan views dari API pihak ketiga itu snapshot di satu waktu. Kalau dipakai di artikel atau laporan, tulis tanggal pengambilannya. Kalau angkanya penting sekali, cross-check ke sumber resmi.
Ini nyambung dengan yang saya tulis soal algoritma X November 2026: metrik itu berubah cepat, jadi agent yang melaporkan angka tanpa tanggal itu agent yang malas.
4. Hormati rate limit
1.000 request per menit per IP itu longgar, tapi bukan undangan buat scraping massal. Kalau agent kamu mulai looping baca ribuan post, itu sinyal desainnya salah. Untuk kebutuhan berat, dokumentasi FxEmbed sendiri menyarankan self-host instance kamu sendiri, dan panduan self-hosting-nya tersedia.
5. Satu tool baru = satu entri di audit
Setiap kali kamu ngajarin agent pakai layanan baru, catat. Kenapa dipakai, data apa yang dikirim, dan kapan harus dicabut. Saya bahas cara audit seperti ini di audit plugin dan connector AI agent. Layanan read-only yang cuma menerima ID post publik itu risikonya kecil, tapi tetap harus tercatat.
Kapan browser tetap benar
Saya bukan anti-browser. Browser tetap jalan yang tepat kalau:
- Tugasnya memang butuh aksi: posting, membalas, mengisi form, setting akun.
- Datanya cuma ada di UI dan nggak ada API yang wajar.
- Kamu perlu lihat tampilan visual persis seperti yang dilihat manusia.
Selain itu, membaca lewat browser itu seperti menyuruh orang nyetir ke kantor pos buat ngecek satu angka yang sebenarnya bisa ditanya lewat telepon.
Penutup
Prinsipnya bukan soal FxTwitter. Prinsipnya: agent harus memilih jalur data paling sempit yang masih menjawab pertanyaan.
Untuk post X publik, saat ini jalur itu adalah satu request JSON. Besok mungkin berubah. Yang penting, aturannya tertulis, pagarnya jelas, dan browser jadi cadangan, bukan refleks pertama.
FAQ
Apakah FxTwitter API butuh API key?
Di halaman API overview FxEmbed saya tidak menemukan syarat API key, dan endpoint publik yang saya tes jalan tanpa key. Semua contoh di artikel ini jalan dengan curl biasa tanpa header khusus.
Apakah bisa dipakai untuk baca bookmark atau DM?
Tidak. Itu data pribadi akun kamu. Pakai jalur resmi yang login sebagai kamu, dan jangan pernah serahkan cookie atau token ke layanan pihak ketiga.
Apakah aman dipakai untuk produk komersial?
Untuk eksperimen dan workflow pribadi, cukup. Untuk produk komersial atau volume besar, pakai X API resmi atau self-host FxEmbed, karena layanan publiknya tidak berafiliasi dengan X dan tidak ada jaminan ketersediaan.
Bagaimana kalau API-nya error?
Cek field code. Kalau bukan 200, agent sebaiknya berhenti dan melapor, atau pindah ke fallback yang kamu tentukan. Jangan biarkan agent menebak isi post.
Bisa dipakai untuk Bluesky juga?
Bisa. FxEmbed juga punya FxBluesky API di https://api.fxbsky.app dengan bentuk response yang mirip.
← Artikel Sebelumnya
Paket Pemulihan AI Agent: Backup Sebelum Akunnya Hilang
Artikel Selanjutnya →
Kuota AI Agent Cepat Habis? Yang Boros Itu Jadwalnya, Bukan Modelnya
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.