
Kuota AI Agent Cepat Habis? Yang Boros Itu Jadwalnya, Bukan Modelnya
Ada pola yang sering saya lihat di orang yang baru serius pakai AI agent: minggu pertama semangat, bikin banyak routine, banyak bot, semua dikasih tugas. Lalu dua hari setelah kuota reset, usage sudah mentok.
Bukan cerita karangan. Ada yang cerita di X weekly usage-nya sudah 100% padahal baru 2 hari sejak reset, sementara reset berikutnya masih 5 hari lagi.
Reaksi pertama biasanya: "modelnya boros" atau "harus upgrade plan".
Menurut saya, sebagian besar kasus bukan soal model. Yang boros itu cara kita menjadwalkan dan menyusun kerja agent.
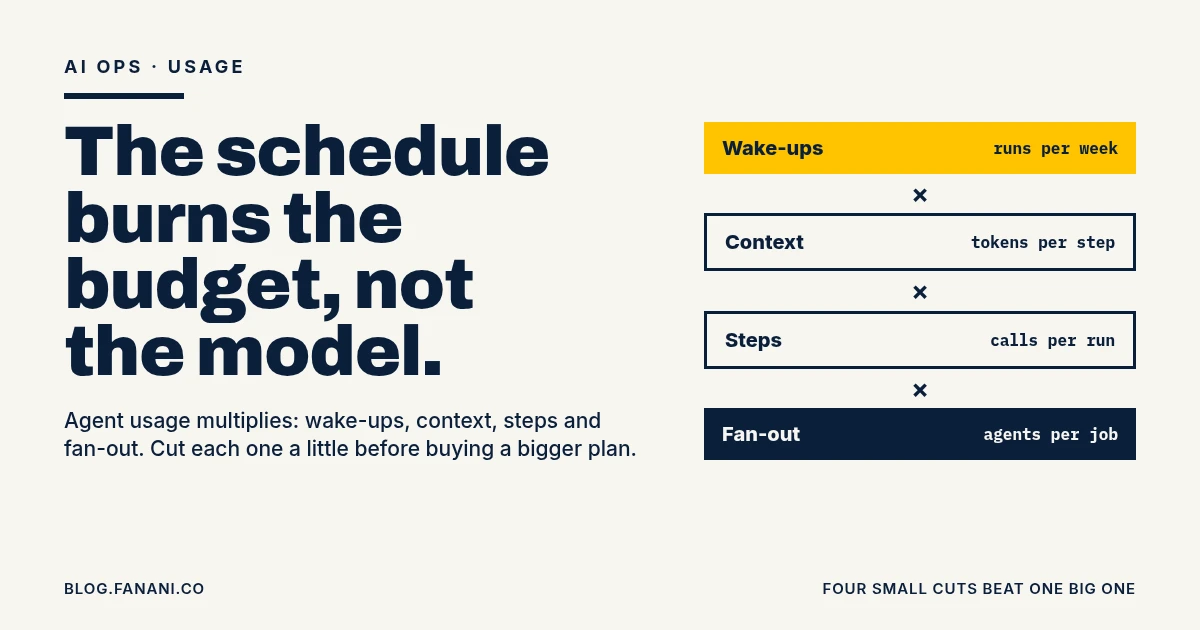
Usage agent itu perkalian, bukan penjumlahan
Framing paling rapi yang saya temukan datang dari thread @vartekxx. Intinya, usage agent bisa dibaca sebagai satu persamaan:
usage ≈ wake-ups × context × steps × fan-out
- Wake-ups: berapa kali agent dibangunkan (routine, cron, trigger).
- Context: berapa banyak teks yang dibawa setiap kali agent mikir (system prompt, memory, histori chat, definisi tool).
- Steps: berapa langkah atau tool call per sekali jalan.
- Fan-out: berapa agent yang ikut mengerjakan atau membalas satu hal.
Ini framework, bukan rumus billing resmi dari vendor mana pun. Tapi logikanya cocok dengan cara kerja API model.
Kenapa perkalian itu penting? Karena empat potongan kecil lebih nendang daripada satu potongan besar. Kalau masing-masing faktor kamu kurangi setengah, totalnya tinggal 1/16. Sementara kalau cuma satu faktor yang kamu babat habis-habisan, tiga faktor lain tetap jalan penuh.
Lesson: sebelum upgrade plan, cek dulu faktor mana yang paling gemuk.
Wake-ups: routine yang rajin itu mahal
Ini faktor yang paling sering diremehkan.
Routine "cek tiap 15 menit" kedengarannya ringan. Tapi hitung saja: 4 kali per jam × 24 jam × 7 hari = 672 kali per minggu. Bandingkan dengan brief pagi di hari kerja: 5 kali per minggu.
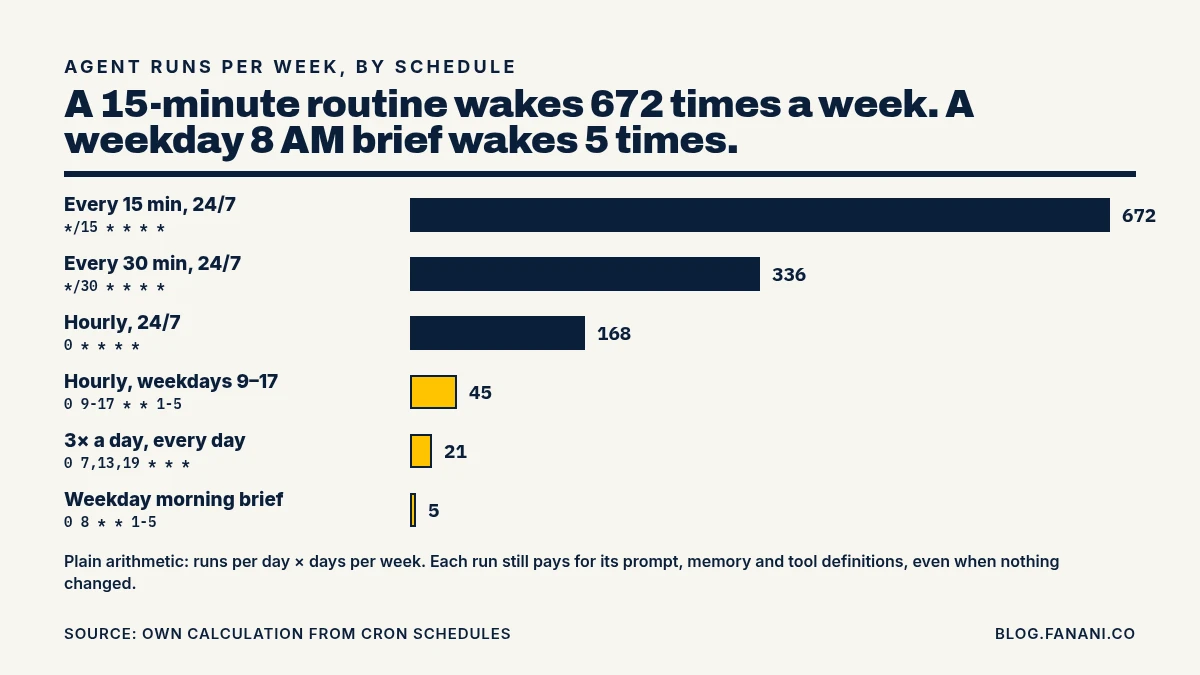
Setiap kali bangun, agent tetap harus membaca instruksinya, memory-nya, dan definisi tool-nya. Walaupun hasil akhirnya cuma "nggak ada yang berubah".
Ada detail teknis yang bikin ini makin terasa. Di dokumentasi Anthropic soal prompt caching, cache default umurnya 5 menit. Cache read dihitung jauh lebih murah (umumnya 0,1× harga input normal, dengan beberapa pengecualian per model). Artinya routine yang jalan tiap 15 menit biasanya sudah lewat dari umur cache default, jadi prefix-nya diproses ulang dari awal. Platform agent yang kamu pakai mungkin punya mekanisme sendiri, tapi prinsipnya sama: bangun jarang-jarang itu mahal per run, bangun sering-sering itu mahal per minggu.
Yang saya lakukan:
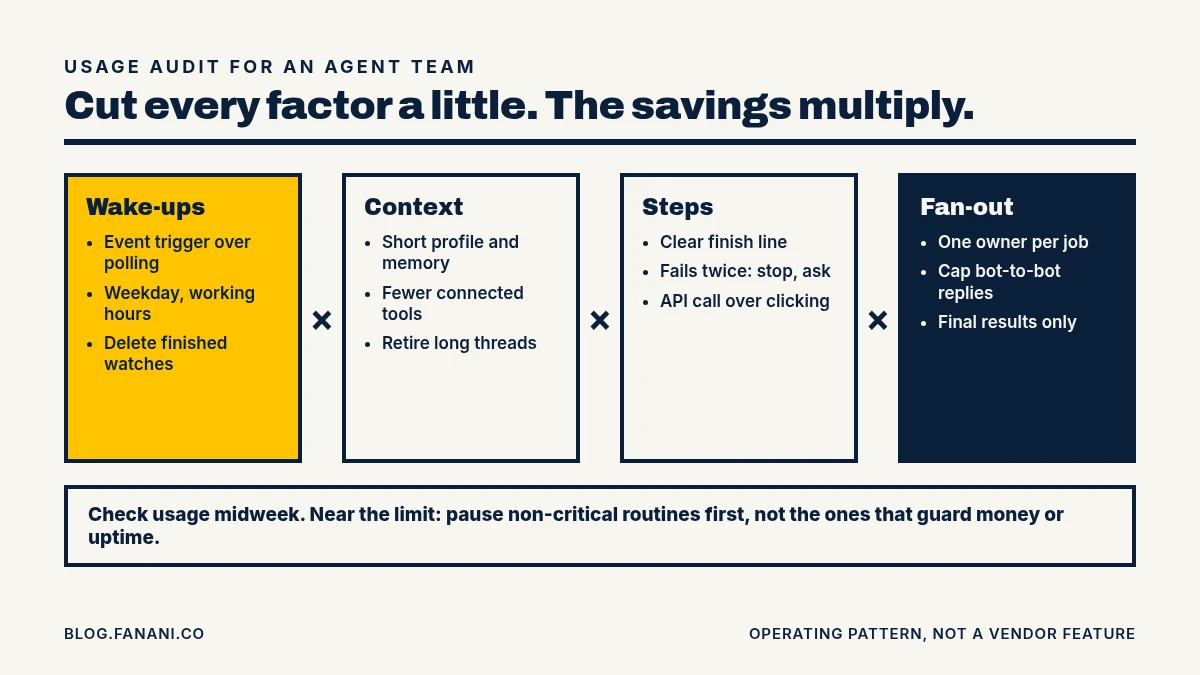
- Ganti polling dengan trigger kalau sumbernya mendukung. Mau tahu ada email masuk? Pakai trigger email, jangan cek inbox tiap 15 menit. Mau tahu PR di-merge? Pakai event GitHub.
- Batasi jam dan hari. "Cek rutin" hampir selalu artinya hari kerja, jam kerja.
0 9-17 * * 1-5itu 45 run per minggu, bukan 168. - Hapus watch yang sudah selesai. Routine "pantau sampai rilis" yang lupa dimatikan itu bocor diam-diam.
- Test run juga dihitung. Jangan iseng klik "run now" sepuluh kali buat lihat hasilnya.
Prinsipnya: sistem yang sehat tidak perlu cerewet.
Context: semua yang ikut naik di setiap langkah
Banyak orang mengira yang dihitung cuma pesan terakhir. Salah.
Dokumentasi context window Anthropic jelas: setiap turn, input-nya berisi seluruh histori percakapan sebelumnya plus pesan baru. Dan yang dihitung masuk context itu semuanya: system prompt, semua pesan (termasuk hasil tool, gambar, dokumen), dan definisi tool.
Jadi agent yang sudah enam minggu ngobrol di satu thread membawa enam minggu histori itu ke setiap balasan. Profile dan memory yang panjang ikut naik di setiap step, ribuan kali seminggu.
Yang bisa dipangkas:
- Profile dan memory: tulis fakta yang memang dipakai, bukan semua yang pernah terjadi. Catatan lama pindahkan ke arsip yang dibaca saat perlu.
- Thread yang kepanjangan: pensiunkan. Bikin handoff note pendek (thread aslinya menyebut sekitar 300 kata), lalu mulai thread baru.
- Tool yang nggak dipakai: setiap connector bawa definisi tool sendiri. Saya sudah bahas cara audit-nya di Plugin Diet.
Kalau mau lebih dalam soal teknik context tiering, saya pernah tulis cara hemat token AI agent dengan lean loading. Artikel ini sudut pandangnya beda: bukan cuma context, tapi keempat faktor sekaligus.
Lesson: memory itu bukan gudang. Memory itu tas yang dibawa ke mana-mana.
Steps: kasih garis finish dan aturan berhenti
Faktor ketiga adalah jumlah langkah per run. Di sini kebocoran paling parah biasanya retry loop: agent gagal, coba lagi, gagal lagi, coba cara lain, dan seterusnya. Setiap percobaan membawa context yang makin panjang.
Aturan yang saya pasang di setiap tugas:
- Definisi selesai yang jelas. "Publish satu artikel dan kirim link" lebih hemat daripada "urus blog".
- Gagal dua kali, berhenti dan lapor. Jangan biarkan agent menebak sampai kuota habis.
- API dulu, klik belakangan. Buka halaman, screenshot, scroll, klik itu banyak langkah. Satu panggilan API atau connector biasanya cukup. Contoh nyatanya ada di artikel saya soal membaca X lewat JSON, bukan browser.
Fan-out: satu pekerjaan, satu pemilik
Faktor keempat sering muncul di tim multi-agent. Taruh empat bot di satu grup chat, tanya satu hal, dan bisa-bisa keempatnya membalas. Satu pertanyaan, empat tagihan.
Belum lagi bot yang saling balas tanpa ujung.
Pola yang saya pakai:
- Satu job, satu owner. Bot lain baru ikut kalau di-mention atau di-delegasikan.
- Batasi obrolan bot-ke-bot. Thread asli menyarankan maksimal 2 pesan. Angkanya boleh kamu sesuaikan, yang penting ada batas.
- Laporan final saja. Nggak perlu update progres tiap langkah kalau nggak ada yang baca.
Kalau agent-mu sering butuh keputusan manusia, kumpulkan dalam satu antrean seperti pola decision inbox, jangan biarkan setiap bot menginterupsi sendiri-sendiri.
Audit 15 menit sebelum upgrade plan
Ini checklist yang saya jalankan kalau usage mulai terasa berat:
Satu lagi: cek usage di tengah minggu, jangan nunggu mentok. Kalau sudah dekat batas, pause routine yang sifatnya "nice to have" duluan. Routine yang menjaga uang atau uptime jangan ikut dimatikan.
Thread @vartekxx mengklaim contoh hasilnya bisa turun dari 2.000 unit ke 400 per minggu dengan job yang sama. Itu angka contoh dari dia, bukan hasil ukur saya. Hasil di setup kamu pasti beda. Tapi arahnya masuk akal, karena faktor-faktornya dikalikan.
Upgrade plan itu sah, asal setelah audit
Saya nggak anti upgrade. Kalau kerjaannya memang banyak dan sudah efisien, bayar lebih itu wajar.
Yang saya nggak setuju adalah upgrade untuk menutupi routine 24/7 yang nggak perlu, thread enam minggu yang nggak pernah dipensiunkan, dan empat bot yang membalas pertanyaan yang sama. Itu bukan butuh kuota lebih besar. Itu butuh operasional yang lebih rapi.
Agent yang hemat itu bukan agent yang dibatasi. Agent yang hemat itu agent yang bangun saat perlu, bawa yang perlu, berhenti saat selesai, dan kerja sendirian kalau cukup sendirian.
FAQ
Kenapa kuota AI agent cepat habis padahal jarang saya pakai?
Karena yang memakai bukan cuma kamu. Routine dan trigger tetap jalan saat kamu tidur. Routine tiap 15 menit sudah 672 run per minggu, dan setiap run membawa instruksi, memory, serta definisi tool.
Apakah ganti ke model yang lebih murah langsung menyelesaikan masalah?
Membantu, tapi tidak menyentuh akar masalahnya. Kalau wake-ups, context, steps, dan fan-out tetap gemuk, model murah pun akan habis dengan pola yang sama.
Lebih baik routine terjadwal atau trigger event?
Trigger, kalau sumbernya mendukung (email masuk, mention, event GitHub, webhook). Jadwal tetap cocok untuk pekerjaan yang memang berbasis waktu, seperti brief pagi atau laporan mingguan.
Seberapa panjang memory agent yang ideal?
Tidak ada angka pasti. Patokan saya: kalau sebuah fakta tidak dipakai di sebagian besar run, pindahkan ke arsip yang dibaca saat perlu, jangan taruh di profile yang ikut setiap langkah.
Apakah prompt caching membuat routine sering jadi murah?
Hanya kalau jaraknya masih dalam umur cache dan prefix-nya identik. Di API Anthropic, cache default berumur 5 menit, dan cache hilang kalau bagian awal prompt berubah, misalnya karena timestamp ditaruh di depan.
← Artikel Sebelumnya
AI Agent Baca X Tanpa Browser: Satu Request JSON, Bukan Klik
Artikel Selanjutnya →
Satu AI Agent untuk 10 Kerjaan? Pecah Jadi Tim, Pasang Chief of Staff
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.