
Code Review di Era AI Agent: Belajar dari Tim Claude Code
Kalau AI agent sudah bisa bikin pull request lebih cepat daripada kita bisa membacanya, pertanyaannya bukan lagi "AI-nya pintar atau nggak".
Pertanyaannya: siapa yang review, dan review apa?
Di artikel sebelumnya, AI Coding Agent Bikin Kode Naik, Tapi Review Jadi Leher Botol, saya bahas masalahnya: kode dan PR naik, tapi review melar. Sekarang ada jawaban yang cukup konkret dari tim yang paling "kebanjiran" kode AI, yaitu tim Claude Code di Anthropic.
Mereka menulis prosesnya secara terbuka di How the Claude Code team does code review (15 Oktober 2026). Ringkasan yang ramai dibagikan di X, misalnya thread ini, bikin banyak orang langsung mau copy-paste. Saya sarankan jangan copy-paste. Pahami dulu logikanya.
Masalahnya bukan malas review, tapi volume
Beberapa angka dari tulisan Anthropic itu, apa adanya:
- Mereka bilang Claude menulis sekitar 90 persen kode Claude Code sendiri.
- Di monorepo Anthropic, perubahan yang landing per hari naik dari sekitar 2.500 di bulan Mei jadi lebih dari 30.000 di bulan September.
- Dari Juni ke September, merged PR ke codebase Claude Code lebih dari dua kali lipat, sementara porsi yang harus di-revert turun lebih dari 40 persen.
Dengan volume begitu, review baris per baris oleh manusia jelas nggak masuk akal.
Yang menarik, mereka nggak menghapus review. Mereka mengubah pertanyaannya. Bukan lagi "apakah manusia sudah membaca kodenya?", tapi "apa yang bisa salah dari perubahan ini, dan check mana, otomatis atau manusia, yang paling tepat untuk menangkapnya?"
Lesson: "sudah dibaca manusia" itu proxy yang buruk untuk "sudah aman".
Tujuh lapis, bukan satu gerbang
Dulu review itu gerbang di ujung jalan: tulis kode, buka PR, tunggu kolega. Sekarang review jalan terus, mirip spellcheck saat kita mengetik.
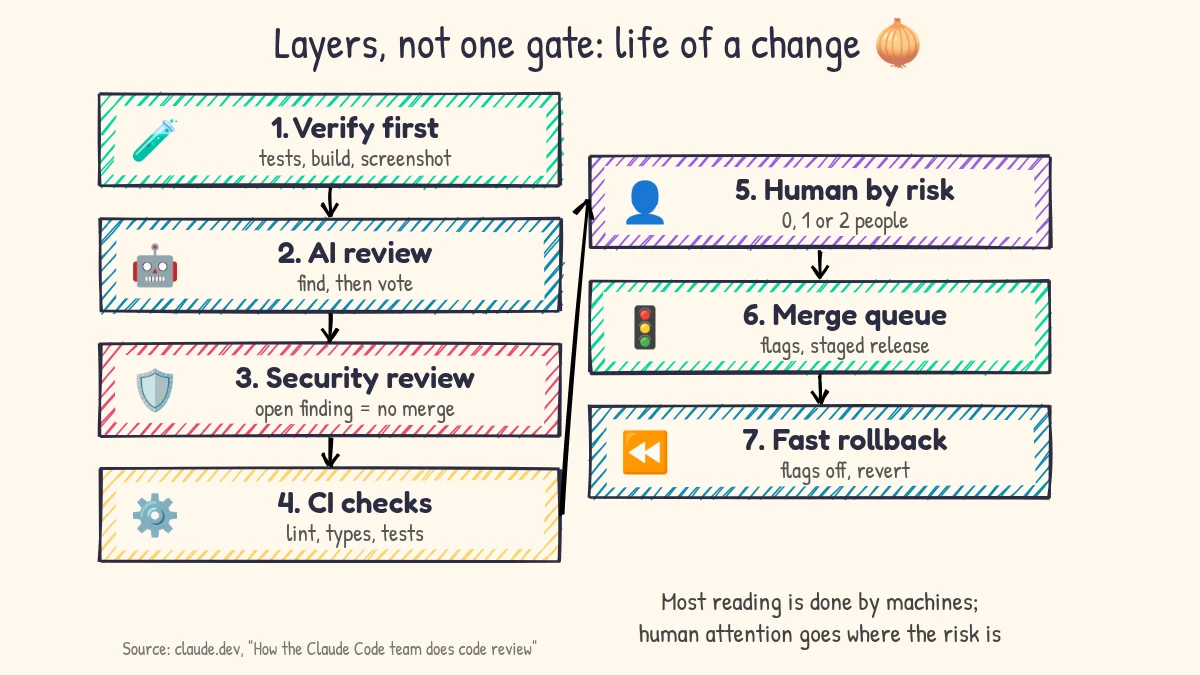
Versi singkat dari alurnya:
- Verify dulu sebelum ada PR. Agent dikasih sesuatu yang bisa dijalankan (test, build, screenshot pembanding desain) dan diminta menunjukkan output, bukan sekadar bilang "done". Lalu subagent dengan konteks segar me-review diff.
- AI review di setiap PR. Beberapa agent mencari bug paralel, lalu kelompok agent terpisah voting tiap temuan. Temuan cuma diposting kalau cukup banyak yang setuju itu nyata. Komentar yang cuma soal style dibuang.
- Security review yang bisa memblokir. PR nggak bisa merge selama masih ada temuan yang terbuka.
- CI biasa: lint, type check, test, build.
- Approval manusia sesuai risiko. Bukan semua PR butuh orang yang sama.
- Merge queue, feature flag, rilis bertahap.
- Deteksi dan rollback cepat. Flag bisa dimatikan tanpa deploy.
Bagian yang paling saya suka ada di nomor 1. Boris Cherny, pembuat Claude Code, dikutip menyebut bahwa memberi Claude cara memverifikasi kerjanya kemungkinan hal paling penting untuk hasil yang bagus, dengan estimasi hasil akhir 2 sampai 3 kali lebih baik. Ini sejalan dengan yang saya tulis di Agentic AI Butuh Loop, Bukan Cuma Prompt: agent tanpa langkah verifikasi itu cuma generator teks yang percaya diri.
Angkanya, dan cara membacanya
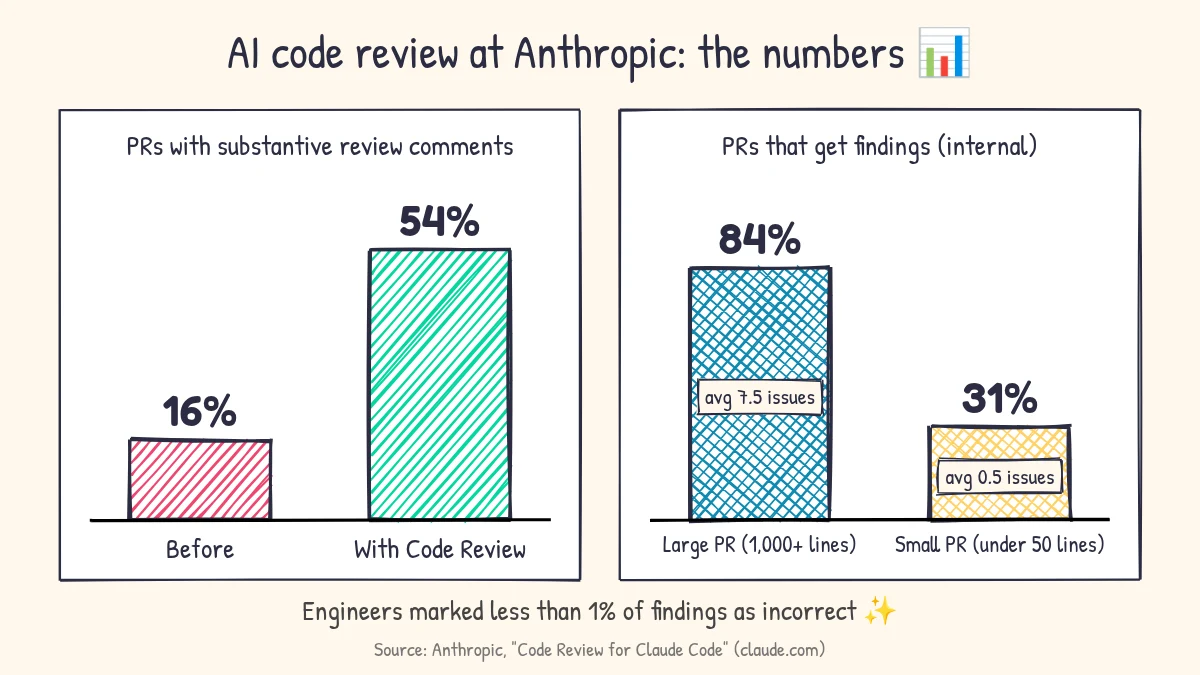
Dari pengumuman Code Review for Claude Code:
- Sebelumnya 16% PR internal dapat komentar review yang substantif. Setelah Code Review dipakai, 54%.
- PR besar (lebih dari 1.000 baris berubah): 84% dapat temuan, rata-rata 7,5 issue.
- PR kecil (di bawah 50 baris): 31%, rata-rata 0,5 issue.
- Engineer menandai kurang dari 1% temuan sebagai salah.
Satu catatan jujur: ini angka internal Anthropic tentang produk Anthropic. Bukan benchmark independen. Saya pakai sebagai arah, bukan janji bahwa repo kamu bakal dapat hasil yang sama.
Tapi pola PR besar vs kecil itu menurut saya pelajaran universal. PR kecil lebih gampang di-review, di-debug, dan di-revert, siapa pun reviewer-nya.
REVIEW.md: tempat kebiasaan review jadi aturan
Ini bagian yang paling gampang ditiru.
Selain CLAUDE.md (konteks proyek: stack, konvensi, goal, non-goal), mereka pakai REVIEW.md yang ditulis code owner. Isinya khusus untuk reviewer. Menurut Anthropic, REVIEW.md yang bagus itu pendek dan:
- bilang seperti apa "gagal" di area itu (untuk docs: "it lies", untuk config: "it misroutes"),
- membatasi jumlah nit,
- daftar path yang di-skip,
- minta bukti file dan baris, bukan tebakan dari nama fungsi,
- minta ringkasan yang dimulai dengan jumlah temuan, dan bilang terus terang kalau nggak ada yang perlu diperbaiki.
Contoh kerangka sederhana yang bisa kamu mulai (ini contoh saya, silakan sesuaikan):
# REVIEW.md

## Yang dianggap gagal di repo ini
- Query database tanpa filter tenant
- Endpoint baru tanpa auth check
- Perubahan config yang bikin request salah arah

## Aturan
- Maksimal 3 nit per review
- Setiap temuan wajib sebut file:baris sebagai bukti
- Skip: dist/, *.lock, file hasil generate

## Format ringkasan
- Mulai dengan jumlah temuan. Kalau 0, bilang "Nothing to fix".
Detail teknis yang penting dari dokumentasi Code Review: REVIEW.md dibaca dari base branch atau default branch, bukan dari perubahan di PR itu sendiri. Jadi PR nggak bisa diam-diam melonggarkan aturan review-nya sendiri. Proteksi default branch kamu.
Lesson: komentar review yang kamu ulang tiga kali harusnya pindah ke REVIEW.md, skill, atau lint rule.
Agent vs agent bisa nggak selesai-selesai
Ini bagian yang jarang dibahas di thread viral, padahal paling relevan buat yang menjalankan agent 24/7.
Anthropic cerita satu PR CLI pernah melewati lebih dari 50 ronde review dan fix semalaman sebelum author-nya menghentikan. Waktu mereka git blame hal yang terus di-flag reviewer, sekitar 59% ternyata kode yang sudah ada sejak pass pertama. Reviewer jarang menemukan bug baru, cuma menemukan sedikit lagi bug lama tiap ronde.
Perbaikannya:
- Batas ronde. Setelah tiga ronde, reviewer minta author mundur dan memikirkan ulang pendekatannya.
- Re-review cuma diff baru setelah beberapa pass awal.
- Flag kelas bug-nya, supaya author memperbaiki semua instance, bukan satu baris.
- Jangan ulang temuan yang sudah diposting.
Ada juga poin halus: noise lebih mahal kalau author-nya agent. Manusia bisa mengabaikan nit dalam hitungan detik. Agent akan memperbaikinya, yang berarti commit baru dan ronde review baru.
Saya sering lihat pola mirip di automation non-coding juga. Dua bot yang saling koreksi tanpa batas cuma membakar token. Ini satu keluarga dengan yang saya bahas di Harness Engineering: Model Sama, Hasil Bisa Beda Jauh: aturan main di sekitar model sering lebih menentukan daripada modelnya.
Manusia tetap pegang yang mahal
Tabel risk tier mereka kira-kira begini:
Beberapa aturan yang menurut saya wajib ditiru:
- Tier ditentukan oleh perubahannya, bukan siapa author-nya.
- Approval agent nggak pernah dihitung sebagai approval manusia.
- Orang yang menyuruh agent ikut bertanggung jawab, sama seperti kalau dia mengetik kodenya sendiri.
- Approval berlaku untuk satu commit. Ada commit baru yang nggak bisa diverifikasi sistem? Approve ulang.
- Path seperti CI workflow dan area yang ditandai sensitif oleh owner selalu butuh manusia.
Dan manusia tetap memutuskan hal yang nggak bisa diotomasi: perlu dibangun atau nggak, arsitektur yang bakal ditiru orang lain, dan kepemilikan hasil.
Ini cocok dengan prinsip yang saya pegang di AI Pribadi Jangan Jadi Black Box: agent boleh kerja banyak, tapi harus ada jejak, bukti, dan orang yang bertanggung jawab.
Cara saya akan mengadopsi ini di tim kecil
Kamu nggak perlu skala Anthropic untuk mulai. Urutan yang masuk akal untuk tim kecil atau solo builder:
- Tulis CLAUDE.md (atau AGENTS.md) pendek berisi command yang bisa agent jalankan: test, lint, build.
- Wajibkan bukti. Agent harus menempelkan output test atau screenshot, bukan cuma "sudah selesai".
- Jalankan review dengan konteks segar sebelum PR dibuka. Di Claude Code ada
/code-reviewdan/security-reviewuntuk ini. - Bikin REVIEW.md dan isi dari komentar review yang sering kamu ulang.
- Tambah tiga field di template PR: Testing, Risk, How to revert.
- Tulis risk tier dan path yang selalu butuh manusia. Mulai ketat, longgarkan pakai bukti.
- Pasang batas ronde review.
- Ukur waktu manusia per PR, dengan revert dan incident sebagai pagar. Kalau revert naik, kamu nggak menghemat waktu, cuma memindahkannya.
Satu peringatan: jangan langsung bikin "zero human merge" karena terdengar keren. Anthropic sendiri menulis bahwa mereka belum punya circuit breaker yang otomatis memperketat approval saat angka revert naik, dan engineer mereka ingin itu ada sebelum lebih banyak kode bergerak tanpa manusia. Kalau mereka saja hati-hati, kita juga.
Penutup
Inti dari cara tim Claude Code ini sederhana: pindahkan pembacaan ke mesin, simpan perhatian manusia untuk risiko, dan bikin kesalahan murah untuk dibatalkan.
Bukan "AI menggantikan reviewer". Lebih tepatnya, reviewer manusia berhenti jadi mesin scan diff dan kembali jadi pengambil keputusan.
FAQ
Apa itu REVIEW.md?
File di root repo berisi instruksi khusus untuk reviewer AI: apa yang dianggap gagal, path yang di-skip, batas nit, dan format ringkasan. Di Code Review for Claude Code, file ini dibaca dari base/default branch, bukan dari PR.
Apakah Code Review for Claude Code meng-approve PR?
Tidak. Menurut dokumentasi Anthropic, review-nya memposting temuan dan check run, tapi tidak meng-approve atau memblokir PR. Keputusan merge tetap di tim.
Siapa yang bisa memakai Code Review for Claude Code?
Menurut Anthropic, fitur ini tersedia untuk paket Claude Team dan Enterprise. Untuk lokal, ada command /code-review versi yang lebih ringan.
Apakah angka 16% ke 54% berlaku untuk semua tim?
Belum tentu. Itu angka internal Anthropic. Pakai sebagai gambaran arah, lalu ukur sendiri di repo kamu.
Kenapa perlu batas ronde review?
Karena agent author dan agent reviewer bisa saling menyibukkan tanpa ujung. Anthropic mencatat satu PR yang lewat lebih dari 50 ronde. Batas ronde memaksa evaluasi ulang pendekatan, bukan tambal sulam terus.
← Artikel Sebelumnya
Harness Engineering: Model Sama, Hasil Bisa Beda Jauh
Artikel Selanjutnya →
HackerTube Karpathy: Agent Kerjakan Semua, Manusia Pegang Kunci
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.