
Harness Engineering: Model Sama, Hasil Bisa Beda Jauh
Kalau agent kamu sering ngaco, refleks pertama biasanya: ganti model.
Upgrade ke model yang lebih baru, naikkan effort, bayar tier yang lebih mahal. Kadang membantu. Tapi sering kali masalahnya bukan di mesinnya.
Masalahnya di harness: semua kode, instruksi, tool, dan aturan yang membungkus model itu.
@N01ennn di X merangkum ini dengan kalimat pendek: same model, different harness, up to 6x performance gap. Saya cek sumbernya, dan klaim 6× itu memang ada di paper riset Stanford. Jadi tulisan ini soal satu hal: kenapa kamu sebaiknya merawat harness sebelum buru-buru ganti model.
Harness itu apa, sih?
Paper Meta-Harness dari peneliti Stanford, MIT, dan KRAFTON mendefinisikan harness sebagai kode yang menentukan informasi apa yang disimpan, diambil, dan ditampilkan ke model.
Dalam bahasa sehari-hari, harness itu:
- system prompt dan file instruksi (
CLAUDE.md,AGENTS.md, skill, rules) - daftar tool atau MCP server yang dicolok
- cara memory diambil dan disuntikkan ke context
- hook, linter, test, dan approval gate di sekitar agent
Model itu mesinnya. Harness itu sasis, setir, rem, dan dashboard-nya.
Di Hermes atau OpenClaw yang jalan di VPS, harness inilah yang paling sering kita ubah tiap hari, sering tanpa sadar. Tambah satu aturan di sini, colok satu MCP di sana. Lama-lama gemuk.
Apa yang benar-benar dibilang paper-nya
Saya mau jujur soal angka, karena post viral sering melebih-lebihkan.
Kalimat "6× performance gap" itu muncul di pendahuluan paper Meta-Harness. Di situ penulis mengutip studi lain bahwa mengganti harness di sekitar model yang sama bisa menghasilkan selisih performa sampai 6× pada benchmark yang sama. Jadi 6× itu bukan hasil eksperimen Meta-Harness sendiri, dan bukan janji bahwa setup kamu bakal 6× lebih bagus.
Hasil eksperimen mereka sendiri (dari abstrak paper):
- Text classification online: harness hasil Meta-Harness unggul 7,7 poin dibanding sistem context management Agentic Context Engineering (ACE), sambil memakai 4× lebih sedikit context token.
- Matematika level IMO: satu harness hasil temuan menaikkan akurasi rata-rata 4,7 poin di 200 soal, diuji di lima model yang tidak dipakai saat pencarian.
- Agentic coding: harness temuannya melampaui baseline buatan tangan terbaik di TerminalBench-2.
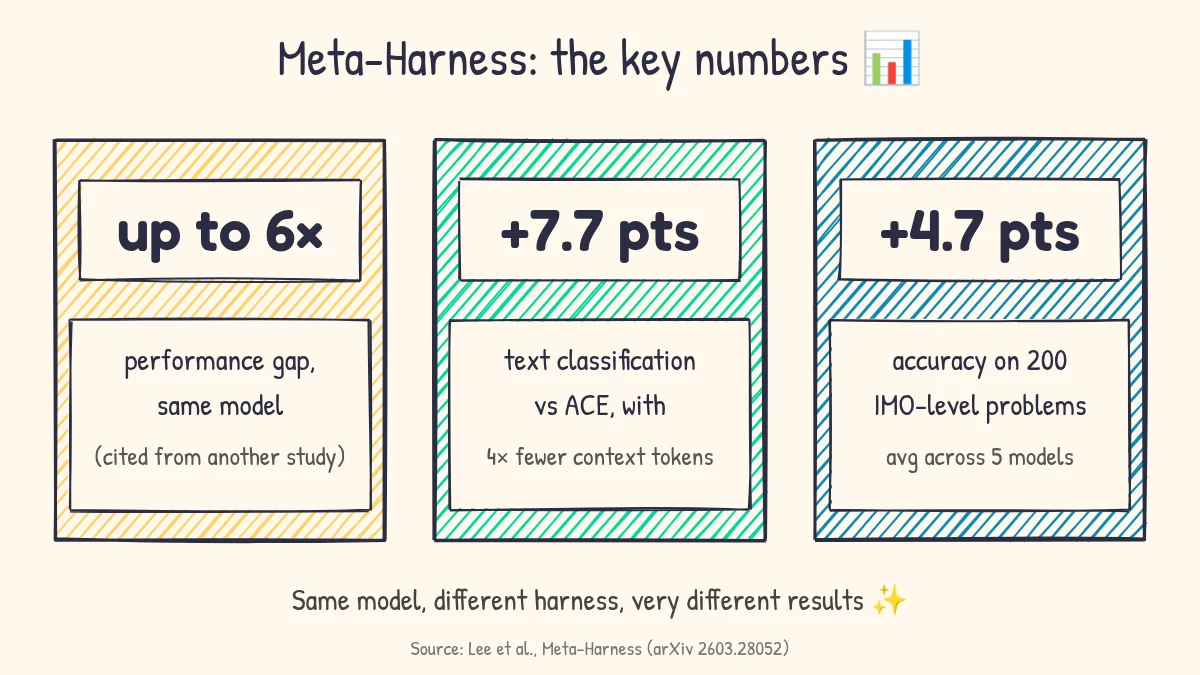
Yang paling menarik buat saya justru poin kedua: lebih akurat dengan context yang lebih kecil. Itu bertentangan dengan insting kebanyakan orang yang terus menjejalkan instruksi tambahan ke agent.
Lesson: context yang lebih banyak bukan berarti agent lebih pintar. Sering justru sebaliknya.
Kenapa harness kita cenderung membusuk
Polanya hampir selalu sama.
Agent salah sekali, kita tambah aturan. Salah lagi di tempat lain, tambah aturan lagi. Ada tool baru yang keren, colok. Tiga bulan kemudian, system prompt-nya ratusan baris, tool-nya puluhan, dan nggak ada yang ingat aturan mana yang masih relevan.
@kloss_xyz pernah cerita hal serupa di X. Dia mengaudit 60+ skill di setup Grok Bot, Claude, dan Codex miliknya, dan menurut pengakuannya tidak ada satu pun yang lolos apa adanya. Ada yang basi, salah, rusak, atau boros.
Saya nggak kaget. Harness itu kayak panel listrik yang terus ditambah MCB tanpa update single line diagram. Masih nyala, tapi nggak ada yang berani bilang kondisinya sehat.
Dan harness gemuk punya risiko lain selain boros token. Tiap MCP yang dicolok adalah permukaan serangan baru. Saya pernah bahas ini di MCP Tool Poisoning.
6 langkah merawat harness
Post @N01ennn menawarkan enam langkah. Saya pakai kerangkanya, dengan catatan praktis versi saya.
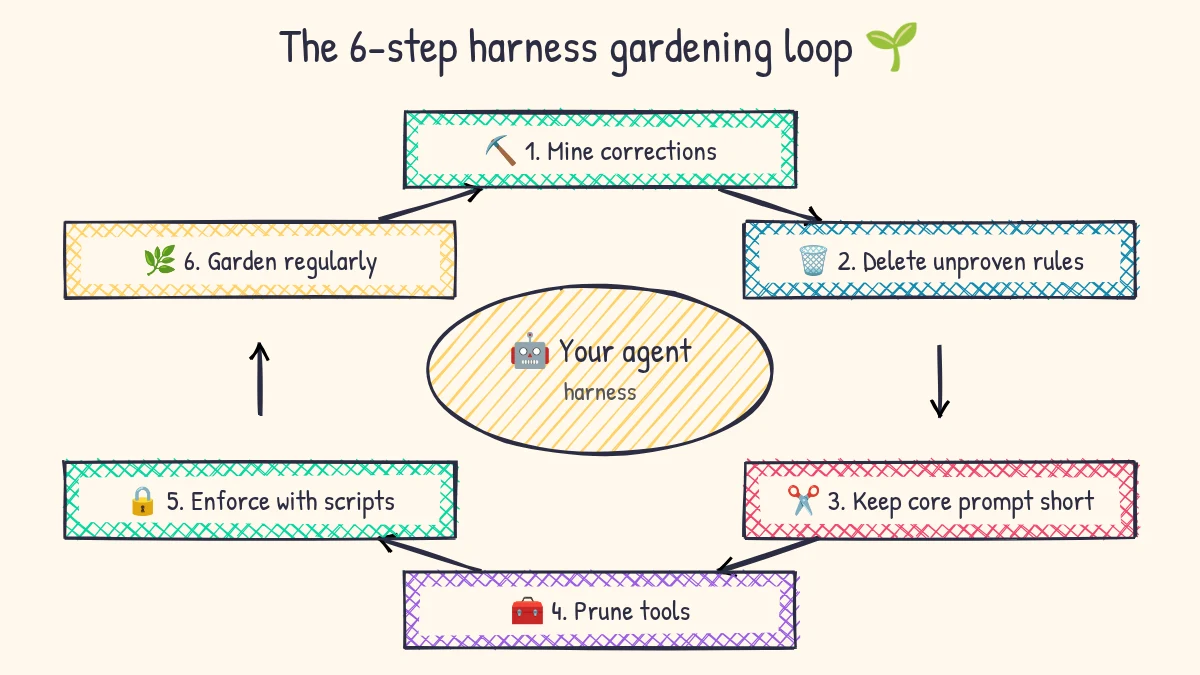
Step 1: Tambang koreksi dari sesi lama
Tiap kali kamu harus mengoreksi agent, itu data. Kumpulkan, lalu ubah koreksi yang berulang jadi aturan.
Kuncinya: berulang. Kesalahan yang muncul sekali belum tentu layak jadi aturan permanen.
Step 2: Hapus aturan yang nggak bisa dibuktikan
Ini langkah yang paling jarang dilakukan, dan menurut saya paling penting.
Kalau sebuah aturan nggak terbukti memperbaiki hasil, dia cuma noise yang makan context. Caranya sederhana: siapkan 5–10 tugas nyata sebagai eval kecil, jalankan dengan dan tanpa aturan itu, bandingkan.
Sama prinsipnya dengan yang pernah saya tulis: automation yang belum terbukti manual cuma mempercepat noise. Aturan agent juga begitu.
Step 3: Instruksi inti tetap pendek
Satu prompt raksasa itu gagal. Post tadi menyarankan sekitar 100 baris yang menunjuk ke file aturan lain yang dimuat saat dibutuhkan.
Angka 100 itu patokan dari post-nya, bukan hukum. Prinsipnya yang penting: yang selalu dimuat harus sedikit, yang spesifik dimuat on demand. Ini nyambung dengan saran Anthropic soal melipat subagent ke single agent loop dengan skill yang dipanggil saat perlu.
Step 4: Pangkas tool
Lebih sedikit tool yang tajam lebih baik dari banyak tool yang tumpang tindih. Model harus memilih di antara semua deskripsi tool, dan tiap deskripsi itu makan context.
Pertanyaan audit yang saya pakai:
- Tool ini dipanggil berapa kali bulan lalu?
- Ada tool lain yang fungsinya sama?
- Kalau dicabut, tugas apa yang gagal?
Kalau jawaban nomor 3 "nggak ada", cabut.
Step 5: Kunci aturan pakai script
Prosa itu saran. Hook, linter, dan test itu jaminan.
Kalau kamu nggak mau agent commit tanpa test lulus, jangan cuma tulis "selalu jalankan test". Pasang pre-commit hook. Contoh sederhana:
# .git/hooks/pre-commit
#!/usr/bin/env bash
set -e
npm run lint
npm test
Agent bisa lupa instruksi. Hook nggak lupa.
Step 6: Gardening rutin
Harness itu kebun, bukan bangunan. Setiap ada perubahan besar (model baru, tool baru, workflow baru), cek ulang. Aturan yang dulu perlu bisa jadi sekarang sudah ditangani model secara native.
Saya suka prompt audit dari @kloss_xyz karena satu detail: dia minta agent menilai dan merencanakan dulu, belum mengeksekusi edit. Itu cara yang aman. Biarkan agent bikin daftar temuan, kamu yang putuskan mana yang dipangkas.
Di mana Meta-Harness relevan buat kita
Meta-Harness sendiri adalah sistem riset: agent yang mencari harness terbaik secara otomatis dengan membaca kode, skor, dan execution trace dari semua kandidat sebelumnya lewat filesystem. Kodenya terbuka di GitHub, tapi README-nya sendiri bilang ini versi rapihan yang belum dites lebih dari sekadar bisa jalan.
Jadi untuk setup harian, saya nggak menyarankan langsung pasang. Yang layak dicuri adalah idenya:
- Simpan trace, bukan cuma skor. Kalau agent gagal, log lengkapnya jauh lebih berguna daripada catatan "gagal".
- Bandingkan versi harness secara eksplisit. Simpan versi lama, ukur versi baru di tugas yang sama.
- Biarkan agent membantu diagnosis, tapi keputusan perubahan tetap lewat manusia.
Ini juga sejalan dengan yang saya tulis soal repair harness untuk daily work: agent bukan cuma harus bisa kerja, tapi bisa dites dan diperbaiki.
Penutup
Model akan terus berganti. Tiap bulan ada versi baru yang lebih pintar.
Tapi harness yang kamu rawat itu milikmu sendiri, dan hasilnya terbawa ke model apa pun yang kamu pakai berikutnya.
Harness terbaik itu kecil, berbasis bukti, dan rajin dipangkas. Sebelum upgrade model, coba buang dulu sepuluh aturan yang nggak pernah kamu buktikan.
FAQ
Apa itu harness dalam AI agent?
Harness adalah semua kode dan konfigurasi di sekitar model: instruksi, tool, memory, hook, dan aturan yang menentukan informasi apa yang disimpan, diambil, dan ditampilkan ke model.
Benarkah harness bisa bikin performa beda 6 kali lipat?
Paper Meta-Harness mengutip studi yang menemukan selisih sampai 6× pada benchmark yang sama dengan model yang sama. Itu batas atas di satu benchmark, bukan jaminan untuk setup kamu.
Lebih baik ganti model atau perbaiki harness dulu?
Menurut saya perbaiki harness dulu. Lebih murah, hasilnya terbawa ke model berikutnya, dan sering memperbaiki masalah yang nggak bisa diselesaikan dengan model lebih besar.
Berapa sering harness perlu diaudit?
Minimal setiap ada perubahan besar: model baru, tool atau MCP baru, atau workflow baru. Di luar itu, audit ringan berkala sudah cukup.
Apakah aman membiarkan agent mengedit aturannya sendiri?
Biarkan agent menilai dan mengusulkan perubahan, tapi review dan approve sendiri sebelum diterapkan. Aturan yang diubah tanpa pengawasan bisa merusak perilaku agent diam-diam.
Sumber: post X @N01ennn dan @kloss_xyz (31 Okt 2026); Lee et al., Meta-Harness: End-to-End Optimization of Model Harnesses; repo stanford-iris-lab/meta-harness.
← Artikel Sebelumnya
GBrain: Satu Memory untuk Semua AI Agent, Tapi Jaga Kuncinya
Artikel Selanjutnya →
Code Review di Era AI Agent: Belajar dari Tim Claude Code
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.