
Subagent Bukan Status: Saatnya Lipat ke Single Agent Loop
Ada fase di mana bikin AI agent rasanya kayak bikin struktur organisasi.
Ada "Router Agent". Ada "Research Agent". Ada "Writer Agent", "QA Agent", "Compliance Agent". Di diagram kelihatan keren, mirip org chart perusahaan besar. Di production? Sering jadi kantor birokrasi: tiap meja oper berkas ke meja lain, dan ada saja berkas yang hilang di jalan.
Akhir Oktober 2026, tim Applied AI Anthropic merilis artikel yang bikin timeline X ramai: Building agents: When to fold subagents into your main agent loop. Intinya: banyak sistem multi-agent sebaiknya "dilipat" balik jadi satu agent loop yang memuat skill dan tool sesuai kebutuhan.
Saya setuju. Bahkan menurut saya ini koreksi yang sudah lama ditunggu.
Kenapa ini ramai sekarang
Satu post di X yang merangkum saran ini tembus sekitar 950 ribu impression (post @cherry_mx_reds). Di Reddit, thread r/ClaudeAI soal kapan nggak membiarkan Claude Code spawn banyak subagent juga membahas keluhan yang sama: subagent makan token dan memperlambat pekerjaan yang saling terkait.
Anthropic juga merilis repo pendamping, anthropics/single-agent-loop-kit. Yang saya suka, kit ini nggak berasumsi single loop selalu menang. Dia mengukur.
Apa yang sebenarnya disarankan Anthropic
Rangkumannya kira-kira begini (silakan baca artikel aslinya untuk detail):
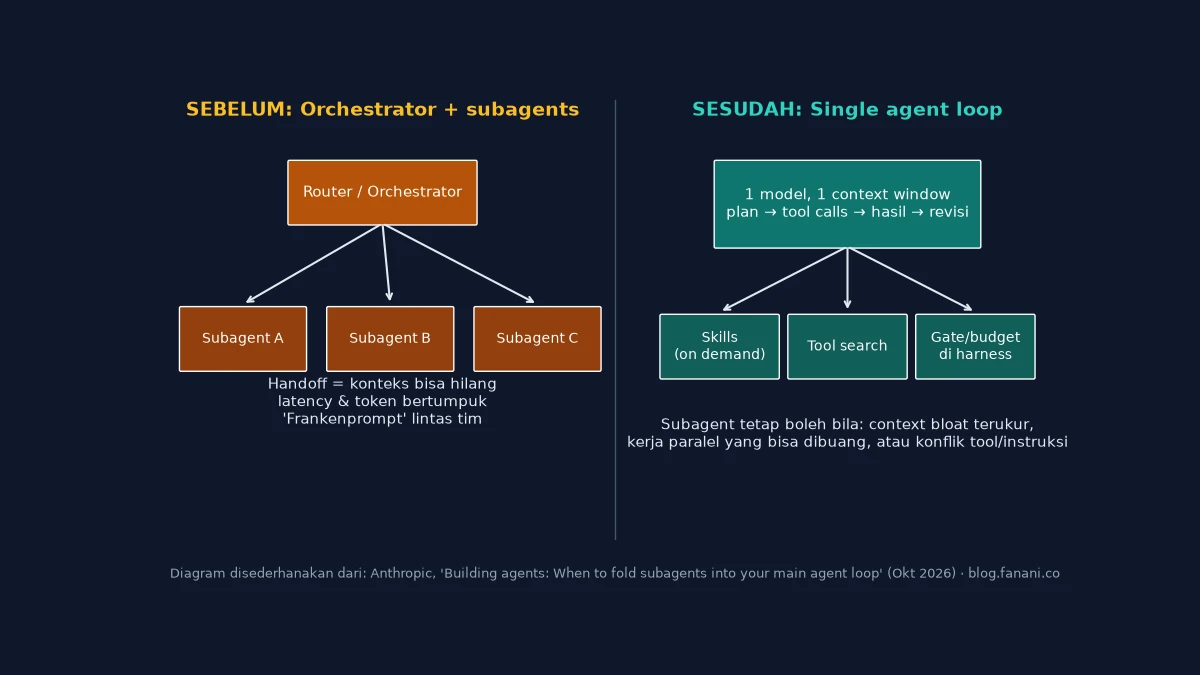
- Satu model, satu context window, menjalankan tool loop terbuka. Batasan seperti budget turn, budget biaya, dan write gate dipasang di harness, bukan di prompt.
- Tiap turn, model mengeluarkan batch tool call. Harness menjalankannya paralel lalu mengembalikan hasil mentah ke model yang sama.
- Model menulis rencana di turn pertama dan merevisinya sendiri saat hasil masuk. Ini perbedaan utamanya: yang bikin rencana adalah yang menjalankan, jadi rencana bisa berubah di tengah jalan.
- Prosedur domain pindah ke skills. Batasan keras (validasi, approval gate) pindah ke tools.
- Skill dan tool di-progressive disclosure: agent cuma lihat deskripsi singkat, isi lengkap dimuat saat dibutuhkan (lewat skills dan tool search).
Artikel itu juga menyebut satu customer melihat runtime kira-kira 2x lebih cepat setelah konsolidasi. Saya catat sebagai anekdot dari Anthropic, bukan benchmark umum.
Subagent bukan dilarang, tapi harus "bayar sewa"
Ini bagian yang sering terlewat di post viral. Anthropic tidak bilang subagent itu salah. Subagent masih masuk akal kalau:
- Single loop mengalami penurunan performa yang terukur karena context bloat.
- Ada kerja paralel yang hasil antaranya boleh dibuang (misalnya eksplorasi banyak cabang lalu cuma ambil ringkasan).
- Agent kesulitan memilih tool yang tepat, atau ada instruksi yang saling bertabrakan di system prompt.
Kalau subagent tetap dipertahankan, sarannya: panggil dia sebagai tool dari agent utama, supaya percakapan dengan user tetap dipegang satu agent.
Opini saya: subagent itu seperti karyawan baru. Dia harus "bayar sewa" berupa peningkatan hasil yang bisa diukur. Kalau cuma bikin diagram terlihat canggih, pecat.
Lesson: jangan pecah agent mengikuti org chart. Pecah hanya kalau eval bilang perlu.
Masalah nyata dari terlalu banyak subagent
Dari artikel Anthropic dan pengalaman komunitas, pola gagalnya mirip:
Poin terakhir ini lucu tapi nyata. Prompt yang ditulis lima tim tanpa owner jelas pasti saling tabrak.
Di artikel lama saya, Agentic AI Butuh Loop, Bukan Cuma Prompt, saya sudah bilang yang bikin agent kuat itu loop-nya. Saran Anthropic ini menurut saya adalah versi enterprise dari prinsip yang sama: loop yang rapi lebih penting daripada jumlah agent.
Cara migrasi yang waras: measure, combine, fold
Kit dari Anthropic memecah prosesnya jadi tiga langkah. Saya terjemahkan ke bahasa praktis:
Step 1: Measure — bikin baseline dulu
Jangan sentuh arsitektur sebelum punya eval. Artikel Anthropic bilang 10 golden examples sudah cukup untuk mulai. Ukur:
- Task completion (apakah tugasnya beres?)
- Latency per task
- Token in/out
- Routing accuracy (selama masih ada orchestrator: apakah subagent yang dipilih benar?)
Repo-nya menyarankan baseline sistem lama dijalankan 2–3 kali dengan model yang di-pin, supaya perbandingannya adil.
Step 2: Combine — gabung yang selalu jalan bareng
Kalau subagent A selalu dipanggil tepat setelah subagent B, itu bukan dua agent. Itu satu agent yang dipotong paksa.
Step 3: Fold — satu per satu
Ubah tiap subagent jadi skill + tools di agent utama, satu per satu, lalu bandingkan dengan eval yang sama. Script compare.py di repo itu punya aturan sederhana yang saya suka: kalau versi baru menyelesaikan task lebih sedikit dari versi sebelumnya, perubahannya nggak dipakai.
Contoh struktur skill sederhana kalau kamu pakai agent di VPS sendiri:
# skills/invoice-followup/SKILL.md (frontmatter)
name: invoice-followup
description: Pakai saat user minta follow-up tagihan yang lewat jatuh tempo.
# Isi lengkap (langkah, template, aturan approval) baru dimuat saat skill dipanggil.
Dan gate keras taruh di tool, bukan di prompt:
def send_email(to, subject, body, approved: bool = False):
    if not approved:
        return {"status": "needs_approval", "preview": body[:500]}
    # ... kirim beneran
Prompt bisa dilanggar model. Kode di tool nggak.
Siapa yang harus pegang system prompt?
Ini rekomendasi organisasi yang menurut saya paling penting tapi paling jarang dibahas: satu tim kecil pusat memegang system prompt dan eval end-to-end, sementara tiap tim domain memegang skill-nya masing-masing beserta eval kecilnya.
Buat bisnis kecil atau solo builder, "tim pusat" itu ya kamu sendiri. Artinya: satu file prompt utama, satu folder skill, satu set eval. Jangan biarkan tiap bot punya prompt liar sendiri.
Kalau kamu sudah punya banyak bot (misalnya satu untuk WhatsApp, satu untuk email, satu untuk ops), pertanyaan yang bagus adalah: apakah ini memang channel berbeda, atau sebenarnya satu otak yang dipotong-potong? Channel boleh banyak. Otaknya sebaiknya sesedikit mungkin. Saya pernah bahas sisi routing-nya di OpenClaw multi-account routing.
Hubungannya dengan biaya token
Satu efek samping yang menyenangkan: progressive disclosure biasanya bikin konteks lebih ramping. Artikel ringkasan i10x mengutip Anthropic bahwa pendekatan ini memangkas system prompt Claude Code lebih dari 80%, dan bahwa pemilihan tool mulai menurun saat agent melihat sekitar 30–50 definisi tool (sumber). Angka itu silakan dicek ke sumbernya, tapi arah logikanya masuk akal.
Kalau kamu concern soal biaya, baca juga Token-Efficient AI Agent. Prinsipnya nyambung: jangan muat yang belum perlu.
Checklist cepat sebelum nambah subagent baru
- Apakah saya punya eval yang menunjukkan single loop gagal di kasus ini?
- Apakah kerja ini benar-benar paralel dan hasil antaranya boleh dibuang?
- Apakah masalahnya sebenarnya cuma skill description yang jelek?
- Apakah gate keamanan sudah ada di tool, bukan di prompt?
- Siapa owner prompt dan eval-nya?
Kalau jawaban nomor 1 dan 2 "nggak", kemungkinan besar kamu nggak butuh subagent. Kamu butuh skill yang lebih bagus.
Penutup
Tren multi-agent itu menarik karena terasa seperti kemajuan. Tapi yang dinilai user bukan jumlah agent. Yang dinilai adalah tugasnya beres, cepat, dan konsisten.
Satu agent yang tahu kapan memanggil skill, dengan harness yang tegas, sering lebih baik daripada sepuluh agent yang saling oper berkas.
Mulai dari satu loop. Tambah kompleksitas hanya kalau angka memintanya.
FAQ
Apakah Anthropic melarang arsitektur multi-agent?
Tidak. Artikelnya menyebut subagent masih punya tempat, termasuk untuk context bloat yang terukur, kerja paralel yang bisa dibuang, dan konflik tool atau instruksi.
Apa itu progressive disclosure di AI agent?
Agent hanya melihat deskripsi singkat skill dan tool. Isi lengkap dimuat saat memang dibutuhkan, sehingga konteks tetap ramping.
Berapa banyak eval yang dibutuhkan untuk mulai?
Anthropic menyebut 10 golden examples sudah cukup sebagai titik awal, lalu dikembangkan ke eval task-completion.
Apakah single-agent-loop-kit bisa langsung dipakai di production?
Repo itu disebut sebagai reference implementation, tidak di-maintain dan tidak menerima kontribusi. Pakai sebagai panduan metode, bukan dependency.
Di mana sebaiknya approval gate diletakkan?
Di tool atau harness. Prompt bisa diabaikan model, sedangkan kode di tool memaksa aturan berjalan.
← Artikel Sebelumnya
MCP Tool Poisoning: Colokan Baru, Celah Baru untuk AI Agent
Artikel Selanjutnya →
Meta Muse Masuk Singapura: Personal AI Agent Mulai Pegang Dompet Kita
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.