
GBrain: Satu Memory untuk Semua AI Agent, Tapi Jaga Kuncinya
Masalah saya dengan banyak AI agent itu bukan soal model.
Soalnya ingatan yang tercecer. Keputusan yang saya ambil di satu chat nggak diketahui agent lain. Hermes tahu konteks VPS, coding agent tahu konteks repo, asisten personal tahu jadwal. Tiap kali pindah harness, saya jadi juru tulis yang ngulang cerita yang sama.
Garry Tan merangkum masalah ini dengan pas di X bahwa tiap harness punya kekuatan masing-masing: Grok/Muse/Dots untuk personal, OpenClaw/Hermes untuk raw power, Claude Code/Codex/Capy untuk codegen. Dan GBrain, katanya, membuat kamu bisa menjalankan konteks yang sama di semuanya.
Saya setuju dengan premisnya. Tapi ada beberapa hal yang menurut saya wajib dipikirkan sebelum kamu memindahkan "otak" ke satu tempat.
Multi-harness itu sudah kenyataan, bukan pilihan
Dulu saya sempat berpikir ideal-nya satu agent untuk semua. Ternyata nggak realistis.
Agent yang jago ngoding belum tentu enak diajak ngatur jadwal. Agent yang jalan 24/7 di VPS belum tentu cocok buat ngobrol dari HP. Jadi wajar kalau kita pakai beberapa harness sekaligus.
Yang jadi masalah: memory-nya ikut terpecah. Saya pernah menulis soal tipe-tipe memory AI agent, dan di situ kelihatan bahwa memory jangka panjang biasanya terkunci di dalam satu agent. Begitu ganti harness, kamu mulai dari nol lagi.
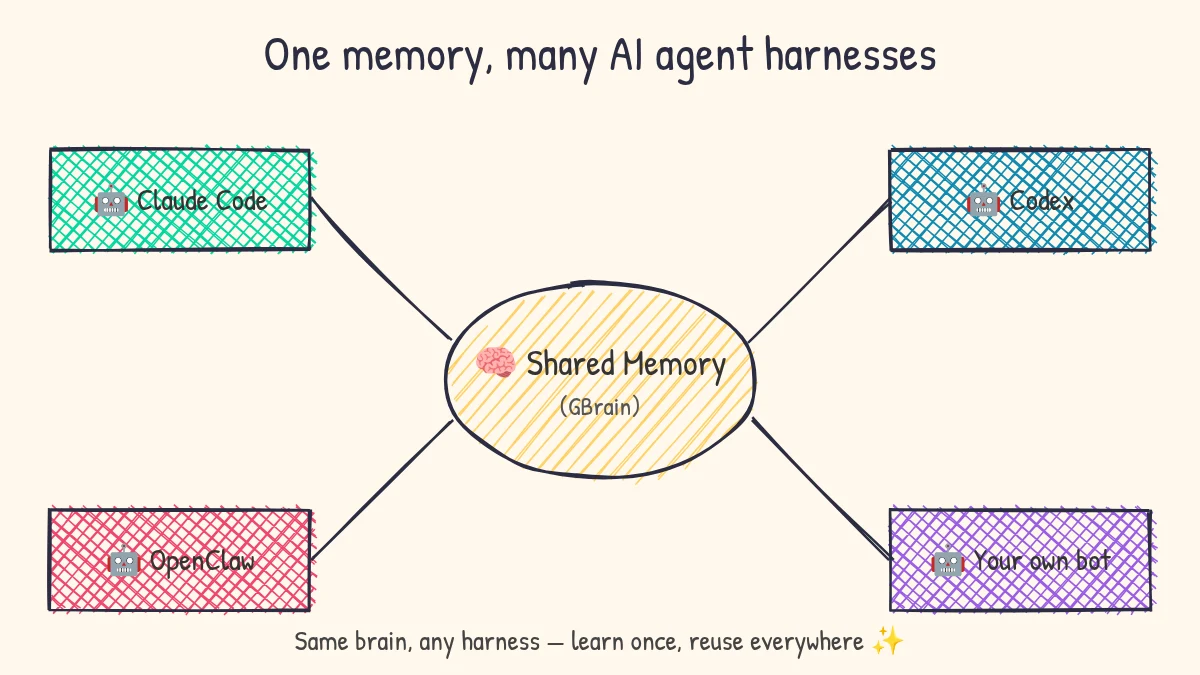
Lesson: kalau kamu pakai lebih dari satu agent, memory adalah infrastruktur, bukan fitur agent.
Apa sebenarnya GBrain
Dari README repo-nya, GBrain adalah memory untuk agent yang sudah kamu pakai. Ia menyimpan fakta eksplisit beserta sumbernya, mendukung koreksi dan penarikan fakta, dan membuat memory yang sama bisa diakses lintas agent.
Ada dua bentuk:
Deskripsi repo-nya sendiri cukup jujur: "Garry's Opinionated OpenClaw/Hermes Agent Brain". Di README, Garry bilang ini adalah brain produksi di balik deployment OpenClaw dan Hermes miliknya, dengan angka 155.795 halaman, 24.589 orang, dan 5.340 perusahaan, plus 66 cron job yang jalan otomatis. Itu klaim dia sendiri, bukan audit independen, tapi cukup buat menunjukkan skala yang dia targetkan.
Untuk versi cloud, panduan setup-nya tergolong unik: kamu cukup suruh coding agent membaca gbrain.io/llms.txt, lalu agent itu yang memandu instalasi.
# contoh dari panduan resmi GBrain Cloud
claude "Read gbrain.io/llms.txt and set me up"
codex "Read gbrain.io/llms.txt and set me up"
Halaman llms.txt itu memang ditulis untuk dibaca AI, bukan manusia. Ini pola yang menurut saya bakal makin umum.
Bagian yang paling saya suka: CLI atau MCP, jangan dua-duanya
Di llms.txt ada aturan yang tegas. Kalau AI-nya bisa menjalankan command (Claude Code, Codex, agent Cursor), pakai command line. Kalau cuma bisa chat (ChatGPT, Claude di web), pakai MCP. Jangan dua-duanya, supaya memory yang sama nggak punya dua pintu masuk.
Ini detail kecil yang sering diabaikan orang. Dua jalur akses ke data yang sama artinya dua set izin yang harus dijaga, dua tempat bug, dua jejak audit. Satu pintu jauh lebih gampang diawasi.
Hal lain yang saya catat dari dokumen yang sama:
- Sign in, bayar, dan pemberian akses terjadi di browser, bukan di terminal. Agent nggak pegang password.
- Agent diminta bertanya dulu sebelum membaca file kamu atau mengirimnya ke GBrain.
- Kalau sebuah command ditolak, agent disuruh berhenti dan kasih link ke orangnya. Bukan cari jalan lain.
gbrain putmenolak menimpa halaman yang sudah ada, kecuali pakai--force, dan itu pun hanya kalau orangnya bilang boleh.
Poin nomor 3 itu penting. Agent yang gagal lalu "kreatif" cari jalan pintas adalah sumber masalah keamanan paling klasik. Saya sudah bahas ini di artikel soal MCP tool poisoning.
Knowledge graph: angka yang layak dicatat (dengan catatan)
GBrain nggak cuma keyword dan semantic search. Ada typed knowledge graph yang menyimpan relasi antar orang, perusahaan, dan ide. Menurut README, pada pertanyaan relasi di BrainBench, relationship retrieval menaikkan R@5 produksi dari 0,6626 ke 0,7241.
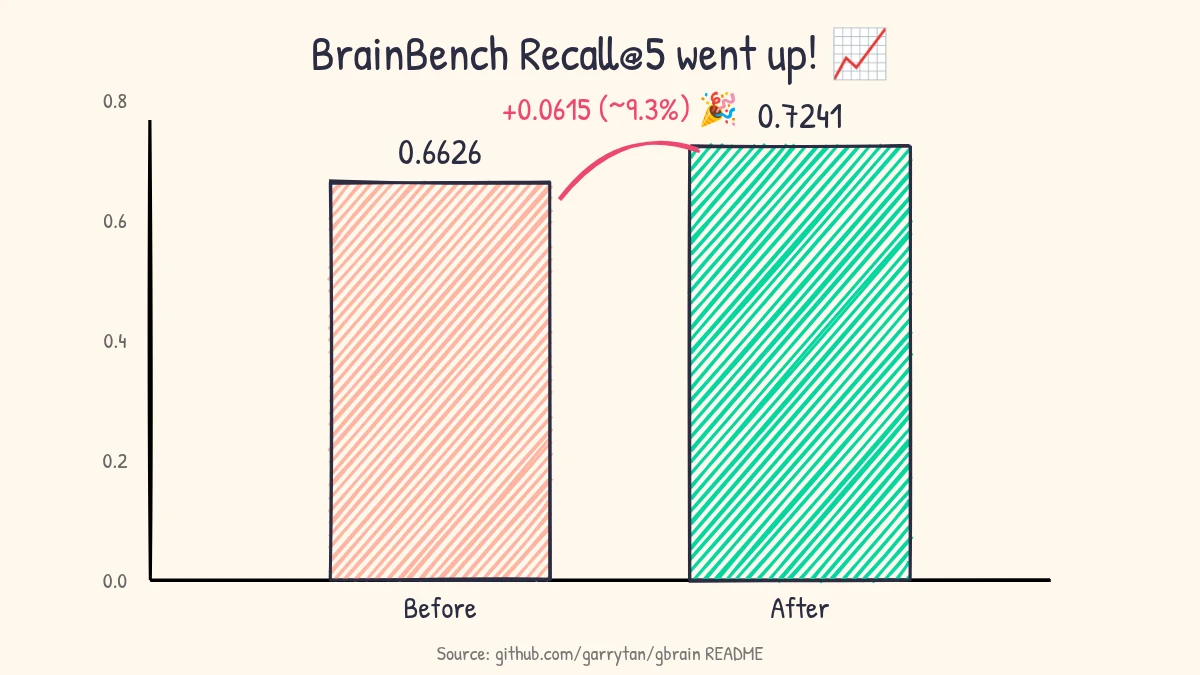
Dua catatan jujur:
- Benchmark ini dibuat oleh tim GBrain sendiri. Bagus untuk melihat arah, belum tentu sama dengan data kamu.
- README juga menyebut angka 0,9791 sebagai upper bound oracle, bukan skor produk. Jangan salah kutip.
Buat use case bisnis, relasi ini justru yang paling berguna. Pertanyaan kayak "siapa saja yang pernah kita hubungi dari perusahaan X?" itu pertanyaan graph, bukan pertanyaan teks.
Yang harus kamu pikirkan sebelum menyatukan memory
Shared memory itu kuat. Tapi kekuatannya sama dengan risikonya.
1. Satu memory bocor, semua agent bocor. Kalau semua harness baca dari satu tempat, maka satu agent yang kena prompt injection bisa membaca semua yang kamu simpan. README GBrain sendiri cukup terus terang: tes otorisasinya menguji jalur akses tertentu, bukan jaminan universal bahwa nggak ada kebocoran. Baca bagian sharing boundaries mereka sebelum dipakai bareng tim.
2. Pisahkan personal dan kerja. GBrain Cloud menyarankan workspace kedua untuk akun pribadi. Ini aturan yang saya pakai juga: data customer dan catatan pribadi jangan satu wadah.
3. Atur izin per AI, bukan per orang. Di halaman gbrain.io, tiap AI punya level izin per akun yang terhubung (misalnya Gmail: Off, Read, Draft, Manage, Full). Prinsipnya sama dengan yang saya tulis di MCP dan governance izin agent di ERP: agent riset cukup Read, agent yang kirim email butuh approval.
4. Memory harus bisa dikoreksi. Fakta yang salah di memory bersama itu menular ke semua agent. Fitur koreksi dan sumber per fakta itu bukan bonus, itu syarat. Ini nyambung dengan prinsip AI pribadi harus bisa diaudit.
Lesson: makin banyak agent yang membaca satu memory, makin ketat aturan siapa boleh menulis ke sana.
Cara saya akan mencobanya
Kalau kamu mau eksperimen, ini urutan yang menurut saya paling aman:
- Mulai dari self-host open source di mesin sendiri, isi dengan catatan yang memang nggak sensitif.
- Sambungkan satu harness dulu, misalnya coding agent lewat CLI. Lihat apakah ia beneran mencari di memory sebelum menjawab.
- Tambah harness kedua, lalu tes: keputusan yang dibuat di agent A, apakah dipakai agent B?
- Baru setelah itu pikirkan data bisnis, izin per akun, dan workspace terpisah.
Jangan langsung tuang semua inbox dan semua dokumen. Saya sudah sering bilang: automation yang belum terbukti manual cuma mempercepat noise. Memory yang diisi sampah juga cuma mempercepat jawaban yang salah.
Penutup
Era satu agent untuk semua sudah lewat. Kita akan pakai beberapa harness, dan itu nggak apa-apa.
Yang perlu disatukan bukan agent-nya, tapi ingatannya. GBrain adalah salah satu jawaban yang serius untuk itu: open source, berbasis file Markdown yang kamu miliki, dengan sumber dan koreksi per fakta.
Tapi ingat, memory bersama itu seperti kunci master. Praktis, dan justru karena itu harus dijaga paling ketat.
FAQ
Apa itu GBrain?
GBrain adalah memory untuk AI agent yang menyimpan fakta beserta sumbernya dan bisa dipakai bersama oleh banyak agent. Ada versi open source (MIT) untuk self-host dan versi hosted di gbrain.io.
Apakah GBrain bisa dipakai dengan OpenClaw dan Hermes?
Bisa. Deskripsi repo-nya bahkan menyebut dirinya sebagai brain untuk agent OpenClaw/Hermes, dan README-nya menyebut itu dipakai di deployment OpenClaw dan Hermes milik Garry Tan.
Lebih baik pakai CLI atau MCP?
Menurut panduan resmi GBrain Cloud: CLI untuk AI yang bisa menjalankan command, MCP untuk AI yang hanya chat. Pilih salah satu per AI supaya memory nggak punya dua pintu masuk.
Apakah aman menyimpan data bisnis di shared memory?
Tergantung batas akses yang kamu atur. Pisahkan workspace pribadi dan kerja, beri izin minimum per AI, dan baca dokumentasi sharing boundaries GBrain dulu. README-nya sendiri menyatakan tes otorisasi bukan jaminan universal tanpa kebocoran.
Apa beda GBrain dengan memory bawaan agent?
Memory bawaan biasanya terkunci di satu agent. GBrain dirancang sebagai catatan eksplisit yang portabel, dengan sumber, bisa dikoreksi, dan bisa diakses lintas harness.
← Artikel Sebelumnya
MCP Sudah Nyambung ke ERP, Tapi Siapa Pegang Kunci?
Artikel Selanjutnya →
Harness Engineering: Model Sama, Hasil Bisa Beda Jauh
Baca Juga

Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.