
Situs Hasil Vibe Coding Belum Selesai: 12 Cek Sebelum Rilis
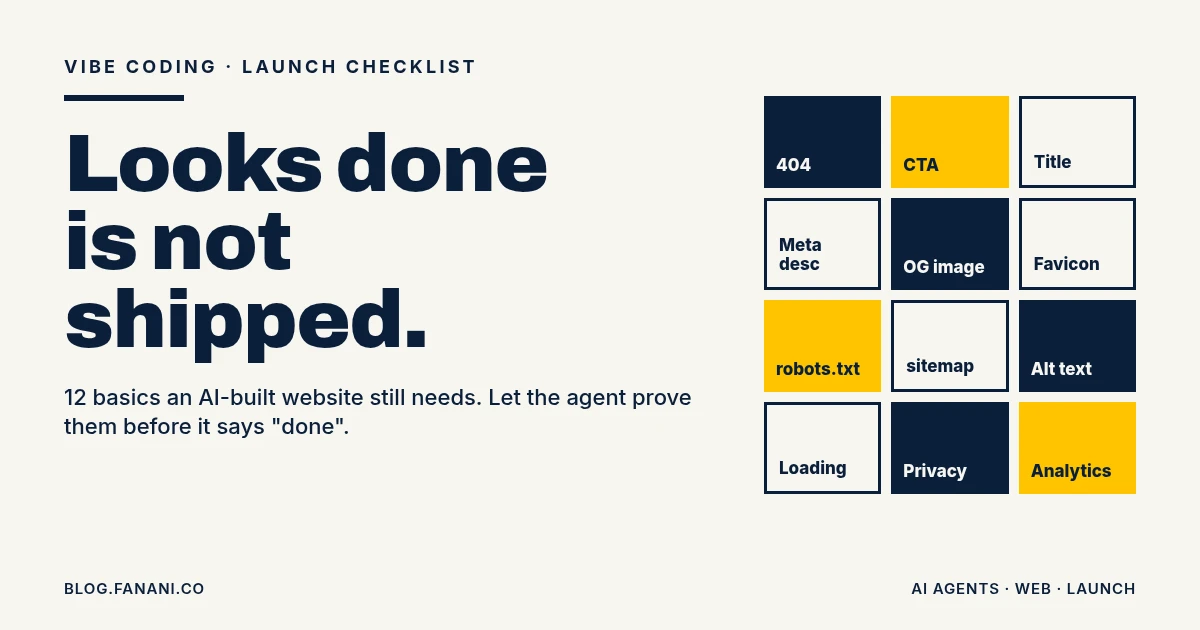
Bikin website sekarang gampang banget. Buka Claude, Cursor, atau Lovable, ketik "bikinin landing page buat jasa saya", dan sepuluh menit kemudian ada halaman yang kelihatan rapi.
Masalahnya, kelihatan jadi dan siap rilis itu dua hal beda.
Pratik Sinha merangkumnya dengan cukup pedas di X: situs hasil vibe coding itu "fake" kalau belum punya 12 hal dasar. Mulai dari custom 404, meta title per halaman, sampai analytics.
Saya setuju dengan daftarnya. Tapi buat saya poin pentingnya bukan di daftar itu sendiri. Poinnya: agent yang bikin situsnya, harusnya agent juga yang wajib membuktikan situsnya lengkap sebelum kamu bilang "done".
Kenapa situs hasil AI sering "setengah jadi"
Model bikin apa yang kamu minta. Kamu minta landing page, dia kasih hero, fitur, testimoni, footer. Halaman yang kamu lihat di browser.
Yang nggak kamu lihat di browser, biasanya nggak dibikin: robots.txt, sitemap.xml, Open Graph tag, favicon set, halaman 404. Semua itu hidupnya di <head>, di root domain, atau di halaman yang nggak pernah kamu klik waktu preview.
Jadi ini bukan soal model-nya bodoh. Ini soal definisi "selesai" yang nggak pernah kamu tulis.
Lesson: kalau definisi selesai cuma "halamannya tampil", agent akan berhenti di situ.
12 item itu, dikelompokkan biar masuk akal
Daftar aslinya berurutan 1 sampai 12. Saya lebih suka mengelompokkannya per fungsi, karena tiap kelompok punya cara cek yang beda:
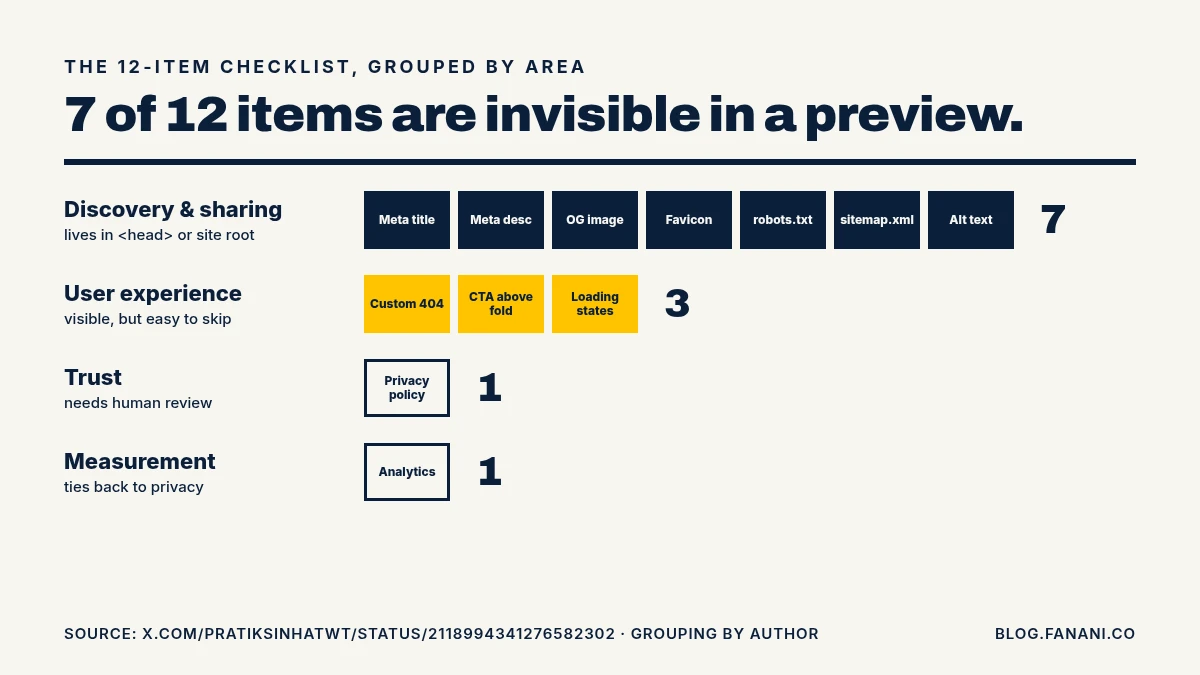
Ditemukan & dibagikan (7 item): meta title per halaman, meta description per halaman, Open Graph image, favicon set, robots.txt, sitemap.xml, alt text di setiap gambar.
Pengalaman pengguna (3 item): custom 404, CTA di atas fold, loading states.
Kepercayaan (1 item): halaman privacy policy.
Pengukuran (1 item): analytics terpasang.
Tujuh dari dua belas ada di urusan "bisa ditemukan dan dibagikan". Dan justru itu yang paling sering hilang, karena nggak kelihatan di layar.
Yang bisa dicek mesin, jangan dicek manual
Kabar baiknya, sebagian besar item di kelompok pertama itu bisa diverifikasi otomatis. Bukan pakai feeling, pakai fakta yang bisa di-curl.
Beberapa patokan resmi yang saya pakai:
- Title: Google minta setiap halaman punya
<title>yang deskriptif dan ringkas, hindari judul generik seperti "Home". - Meta description: Google menyarankan deskripsi unik per halaman. Deskripsi yang sama di semua halaman nggak membantu. Catatan: Google tetap bisa memilih snippet sendiri dari isi halaman.
- Open Graph: spesifikasi ogp.me menyebut empat properti wajib:
og:title,og:type,og:image,og:url. Kalau pakaiog:image, sebaiknya adaog:image:altjuga. - Favicon: panduan Google minta favicon persegi (1:1), minimal 8x8px, dan merekomendasikan lebih besar dari 48x48px. URL-nya juga harus stabil dan nggak diblok
robots.txt. - robots.txt: ini untuk mengatur crawl, bukan untuk menyembunyikan halaman dari Google. Mau halaman nggak masuk index, pakai
noindexatau password. - Sitemap: satu sitemap maksimal 50MB (uncompressed) atau 50.000 URL, pakai URL absolut, dan bisa didaftarkan lewat baris
Sitemap:dirobots.txt. - Alt text: Google pakai alt text untuk memahami gambar, dan itu juga penting buat pengguna screen reader. Jangan diisi keyword stuffing.
- 404: halaman error yang balikin status 200 bisa dianggap soft 404. Jadi custom 404 yang bagus itu bukan cuma desainnya, tapi status code-nya beneran 404.
Semua itu bisa jadi script kecil. Contoh kasar yang bisa kamu suruh agent jalankan setiap kali dia bilang "website sudah selesai":
#!/usr/bin/env bash
# preflight.sh — cek dasar sebelum rilis. Ganti SITE dengan domain kamu.
SITE="https://example.com"

echo "robots.txt: $(curl -s -o /dev/null -w '%{http_code}' $SITE/robots.txt)"
echo "sitemap.xml: $(curl -s -o /dev/null -w '%{http_code}' $SITE/sitemap.xml)"
echo "404 page status: $(curl -s -o /dev/null -w '%{http_code}' $SITE/halaman-yang-tidak-ada-xyz)"

HTML=$(curl -s $SITE/)
for tag in '<title>' 'name="description"' 'property="og:title"' \
           'property="og:type"' 'property="og:image"' 'property="og:url"' 'rel="icon"'; do
  echo "$HTML" | grep -qi "$tag" && echo "OK   $tag" || echo "MISS $tag"
done

# gambar tanpa atribut alt
echo "img tanpa alt: $(echo "$HTML" | grep -oi '<img[^>]*>' | grep -vic 'alt=')"
Ini sengaja simpel. Untuk situs banyak halaman, loop saja semua URL dari sitemap. Yang penting prinsipnya: agent nggak boleh klaim "beres" sebelum output script ini bersih.
Ini mirip yang pernah saya tulis soal code review di era AI agent: yang menulis jangan jadi satu-satunya yang menilai. Minimal ada pemeriksa yang nggak bisa dibujuk.
Yang nggak bisa diserahkan penuh ke agent
Nah, ini bagian yang sering dilupakan orang yang terlalu semangat sama automation.
Beberapa item di daftar itu bukan soal ada atau tidak, tapi soal benar atau tidak.
CTA di atas fold. Agent bisa cek ada tombol atau nggak. Tapi tombol itu ngajak orang ngapain? "Hubungi kami" atau "Minta penawaran"? Itu keputusan bisnis. Agent boleh kasih tiga opsi, kamu yang pilih.
Privacy policy. Agent bisa bikin draft dalam semenit. Tapi isinya harus sesuai apa yang situs kamu benar-benar lakukan: data apa yang dikumpulkan form kamu, analytics apa yang dipasang, disimpan di mana. Kalau situs kamu memproses data pribadi orang Indonesia, ada UU No. 27 Tahun 2022 tentang Pelindungan Data Pribadi yang relevan. Privacy policy hasil copy-paste template yang nggak cocok sama kenyataan itu lebih bahaya daripada kelihatan profesional.
Analytics. Agent bisa pasang snippet-nya. Tapi pasang analytics berarti kamu mulai mengumpulkan data pengunjung. Itu nyambung lagi ke privacy policy. Dua item ini jangan dikerjakan terpisah.
Loading states. Ini relevan kalau situsmu ada interaksi: form submit, fetch data, dashboard. Untuk landing page statis murni, bisa jadi nggak terlalu penting. Jangan centang checklist cuma biar kelihatan lengkap.
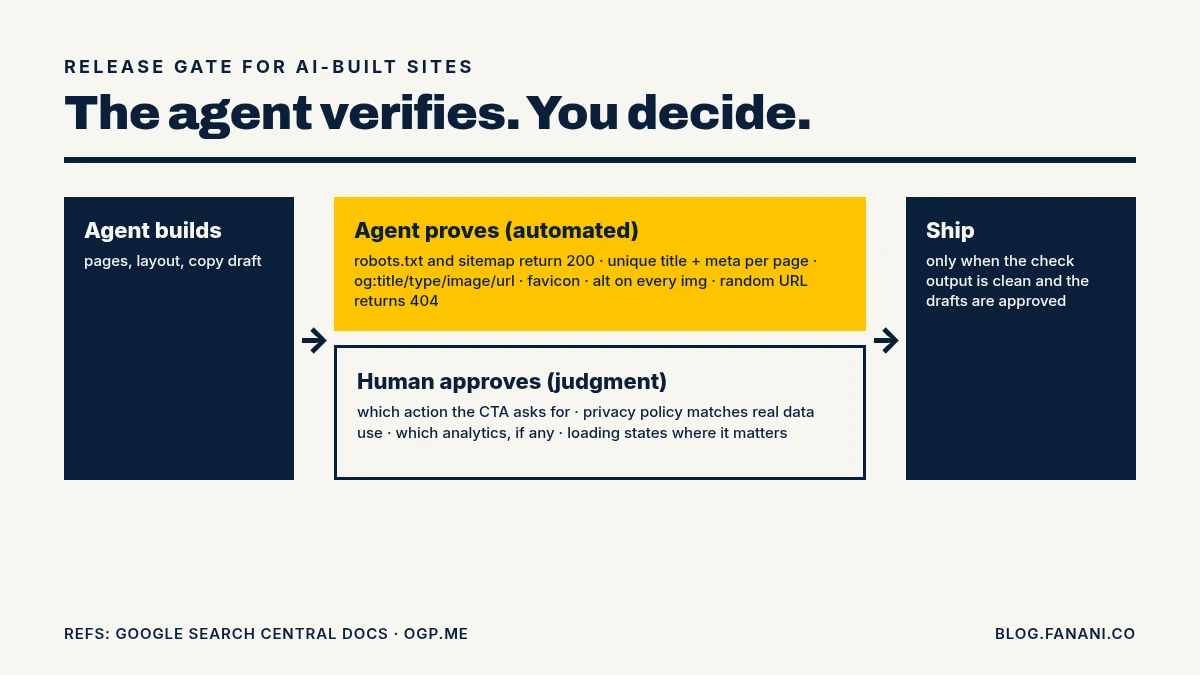
Lesson: agent cek keberadaan dan format. Manusia putuskan isi yang punya konsekuensi bisnis atau hukum.
Cara saya memasang ini di workflow agent
Daripada mengingat 12 item setiap kali, saya lebih suka menaruhnya jadi bagian dari instruksi tetap agent. Tiga langkah:
1. Tulis definisi "selesai" secara eksplisit
Taruh di file instruksi project (misalnya AGENTS.md, CLAUDE.md, atau skill). Contoh:
## Definition of done untuk website
- preflight.sh jalan tanpa MISS
- Setiap halaman punya title dan meta description unik
- URL acak mengembalikan status 404, bukan 200
- Privacy policy dan CTA: buat DRAFT, minta approval saya, jangan publish sendiri
2. Suruh agent menjalankan, bukan cuma melaporkan
Bedanya besar. "Sudah saya tambahkan sitemap" itu klaim. Output 200 dari curl itu bukti. Minta bukti.
Kalau agent kamu bisa pakai browser, suruh juga buka halaman di viewport HP dan cek CTA kelihatan tanpa scroll. Saya pernah bahas kenapa agent yang membaca struktur halaman lewat accessibility tree lebih bisa diandalkan daripada yang cuma lihat screenshot.
3. Catat yang gagal, biar nggak terulang
Kalau agent lupa favicon di project ini, jangan cuma diperbaiki. Tambahkan ke checklist atau ke ledger kesalahan, seperti pola failure ledger yang pernah saya tulis. Project berikutnya, kesalahan yang sama nggak perlu muncul lagi.
Bonus: situs statis bikin semua ini lebih gampang
Kalau situsmu statis (Astro, Hugo, atau sejenisnya), sebagian besar item ini bisa di-generate saat build: sitemap otomatis, meta per halaman dari frontmatter, 404 sebagai file tersendiri. Ini salah satu alasan saya cukup suka arah migrasi dari WordPress ke situs statis: lebih sedikit bagian bergerak, lebih gampang dicek agent.
Penutup
Vibe coding itu nyata dan berguna. Saya pakai juga.
Tapi kecepatan bikin halaman nggak ada artinya kalau halaman itu nggak bisa ditemukan, kelihatan rusak waktu di-share, atau nggak jujur soal data pengunjungnya.
Jadi aturannya sederhana: agent boleh membangun cepat, tapi dia wajib membuktikan situsnya lengkap. Dan keputusan yang menyangkut bisnis dan hukum, tetap kamu yang pegang.
FAQ
Apakah 12 item ini cukup untuk SEO?
Belum. Ini fondasi teknis dasar. SEO yang sebenarnya tetap butuh konten yang berguna, struktur internal link yang jelas, dan performa yang baik. Tapi tanpa fondasi ini, konten bagus pun lebih susah ditemukan.
Apakah robots.txt bisa menyembunyikan halaman admin?
Tidak. Menurut dokumentasi Google, robots.txt hanya mengatur crawling, dan URL yang diblok tetap bisa terindex kalau ada link dari tempat lain. Untuk halaman sensitif, pakai autentikasi atau noindex.
Kenapa halaman 404 harus balikin status 404?
Karena halaman error yang balikin status 200 bisa dibaca Google sebagai soft 404. Pengunjung lihat pesan error, tapi mesin lihat halaman "sukses". Custom 404 yang benar itu desainnya ramah dan status code-nya jujur.
Boleh nggak privacy policy dibuat AI?
Boleh untuk draft. Tapi isinya wajib kamu review dan sesuaikan dengan data yang benar-benar dikumpulkan situsmu. Kalau ragu soal kewajiban hukumnya, konsultasikan dengan orang yang paham hukum, jangan cuma percaya output model.
Perlu analytics berbayar?
Nggak harus. Yang penting ada pengukuran dasar supaya kamu tahu halaman mana yang dikunjungi dan CTA mana yang diklik. Pilih yang sesuai kebutuhan, dan pastikan privacy policy kamu menyebutkannya.
← Artikel Sebelumnya
PhoneUse: Kasih AI Agent iPhone Beneran, Tapi Tombol Kirim Tetap di Kamu
Artikel Selanjutnya →
Hakonfig: Ganti Provider AI Agent Tanpa Edit JSON Manual
Baca Juga




Ada Pertanyaan? Yuk Ngobrol!
Butuh bantuan setup OpenClaw, konsultasi IT, atau mau diskusi project engineering? Book a call langsung — gratis.
Book a Call — Gratisvia Cal.com • WITA (UTC+8)
Newsletter
Subscribe to Newsletter
Artikel baru, automation notes, dan engineering insight. Clean inbox, no spam.
Dengan subscribe, kamu setuju menerima update seperlunya.